Qwen-Image-2.1 开源:7B 一个模型搞定文生图、编辑和透明素材
2026 年 9 月 20 日,阿里通义千问团队开源了 Qwen-Image-2.1。这次发布的关键词是"合并":一个视觉生成部分仅 7B 参数的模型,同时承担了文生图、指令式图像编辑,以及千问图像主线系列首次原生支持的透明(RGBA)图像生成与编辑。此前,千问的图像能力分散在多个专用模型里;2.1 把三者收进同一个权重文件,而且 ComfyUI 已经提供了原生工作流。
在动手之前有一个必须知道的细节:这套权重采用 Qwen Research License(千问研究许可),默认只允许非商业用途。如果你是研究者、ComfyUI 玩家,或者想尝试贴纸与素材工作流的设计师,这没有影响;但如果你打算把它做进产品,就需要向千问单独申请商业授权。
下面是这次发布实际包含的内容、新能力的原理,以及当前已经有文档支持的三种上手方式。
要点速览
- 一体模型:Qwen-Image-2.1 用一个模型完成文生图和图像编辑,视觉生成部分为 7B 参数、32 层 Single-Stream DiT 结构。
- 原生透明:可以直接按提示词生成带透明通道的图像、编辑透明图层内容,还能把普通照片中的主体抠成 RGBA 素材——2025 年 12 月发布的 Qwen-Image-Layered 的能力被并入了这个统一模型。
- 更强的编辑控制:单次任务最多 10 张参考图,支持圈选、涂抹、独立掩码三种局部编辑方式。
- 三种已文档化的上手路径:官方在线 Demo、带 2K 输出与透明通道支持的 ComfyUI 原生工作流、diffusers 的
QwenImage21Pipeline。 - 许可限制:开放权重不等于无限制使用——商用需要与千问另行签约。
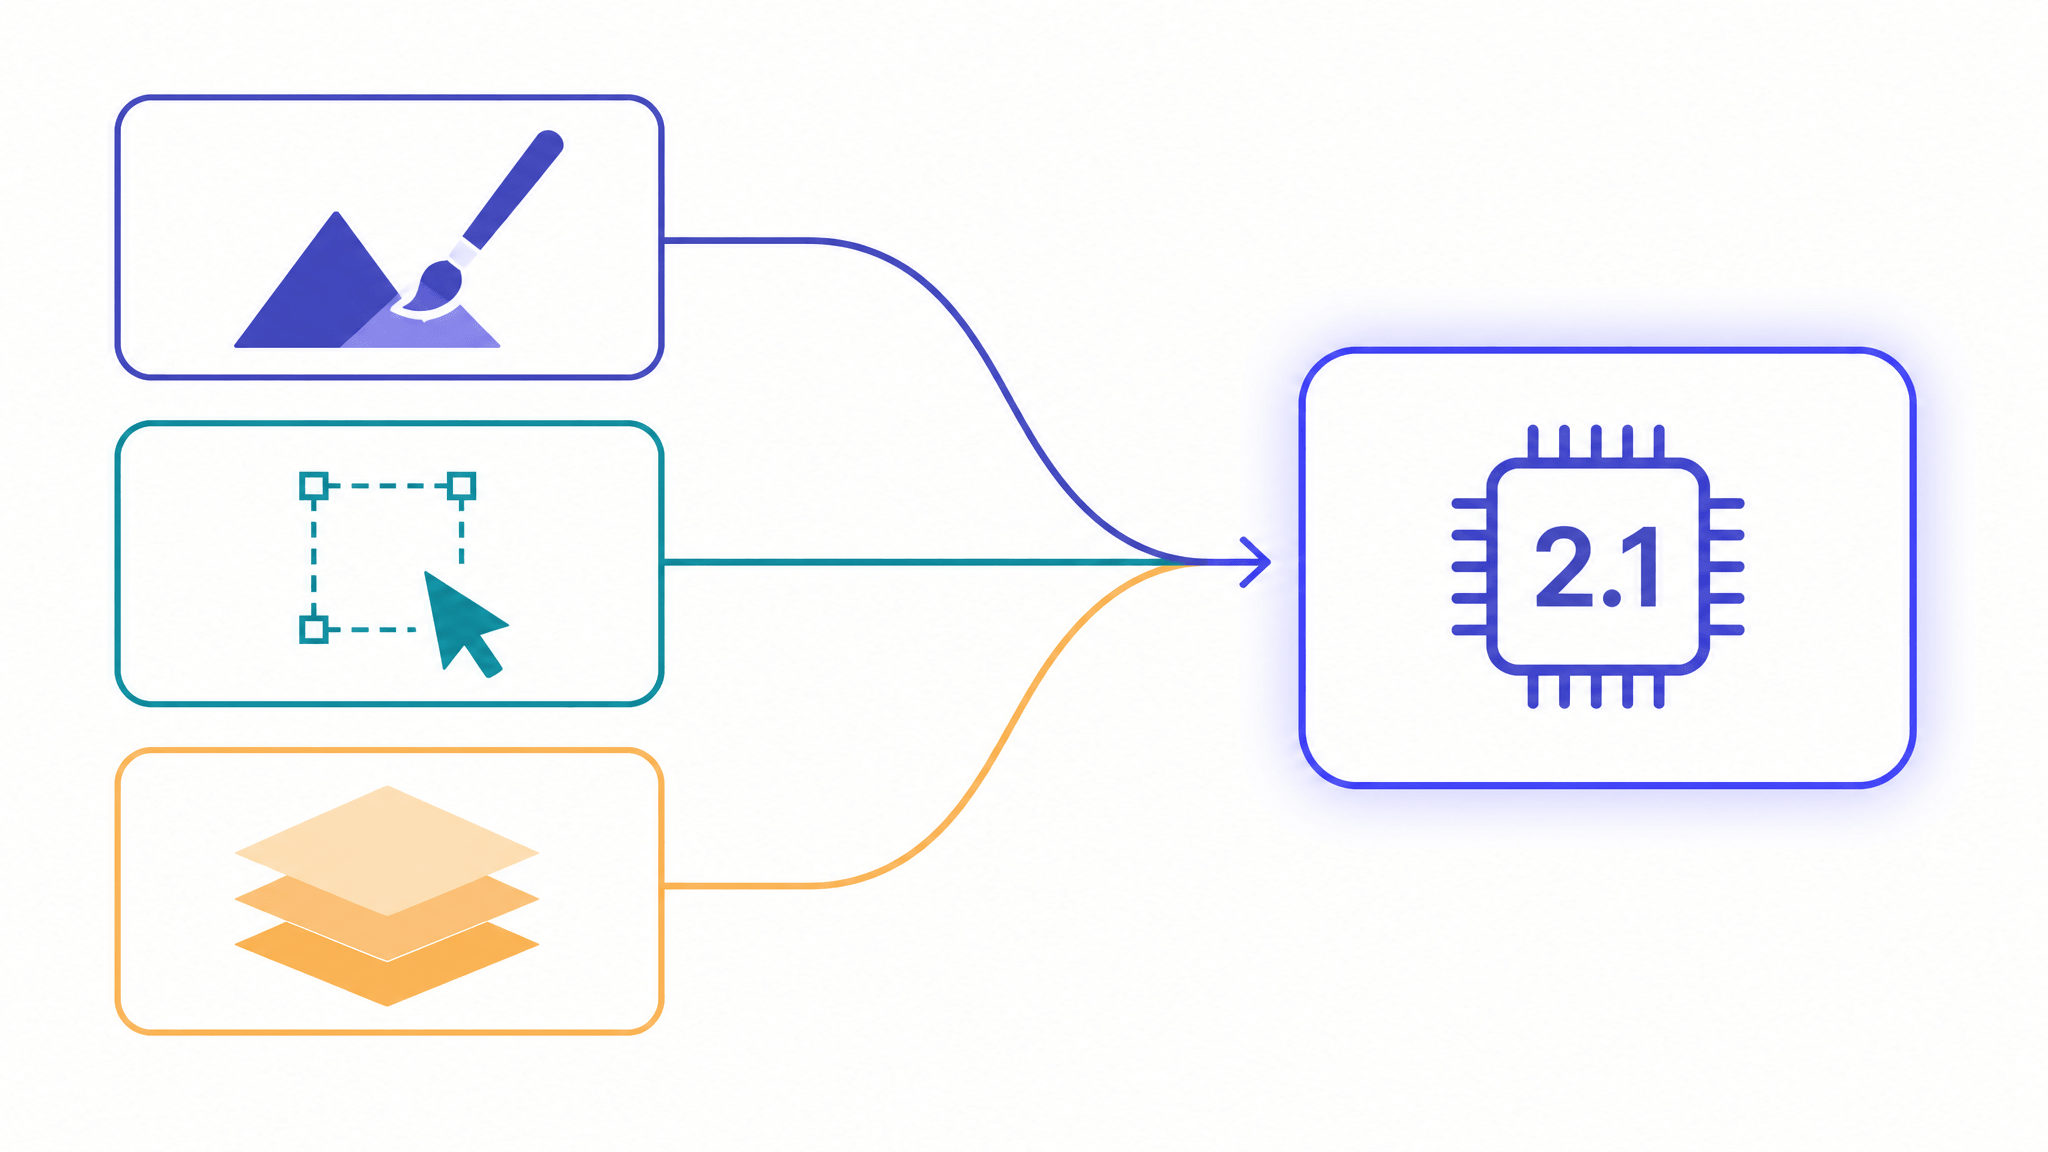
Qwen-Image-2.1 把生成、编辑,以及 2025 年 12 月 Layered 的透明能力,收进同一个 7B checkpoint。
Qwen-Image-2.1 到底是什么
Qwen-Image-2.1 是千问图像系列的最新成员。它的视觉生成部分刻意保持紧凑:7B 参数、32 层 Single-Stream DiT(单流扩散 Transformer)结构。在官方公告中,千问将其定位为系列里生成质量、推理效率与使用成本平衡得最好的开源图像模型。
结构上的变化在于"合一"。此前千问的图像模型是分工的:Qwen-Image 负责文生图,Qwen-Image-Edit 负责编辑,2025 年 12 月发布的 Qwen-Image-Layered 负责透明图像生成。2.1 把编辑与透明能力折叠进了生图所用的同一套权重。官方 ComfyUI 文档的表述很直接:工作流在"生成图像"与"编辑图像"之间切换时,不再需要更换 checkpoint。
模型还会根据提示词自行决定输出模式:描述一个普通场景,得到常规图像;描述一个透明素材,得到带 alpha 通道的图像。不需要单独调用什么"透明模型"。
7B 为什么能打:效率设计
小模型通常要在质量或速度上让步。Qwen-Image-2.1 的效率论证建立在公告中描述的两个机制上:
- 混合粒度注意力。文本 token(系统前缀与编辑指令)使用 token 级因果掩码处理,图像内容则按 chunk 使用 chunk 级掩码。不同类型的内容获得不同的注意力策略,而不是一刀切。
- KV Cache 复用。在编辑任务中,输入图像与编辑指令被当作静态前缀:首步计算一次、缓存,后续步骤直接复用。这减少了重复计算和显存开销——按 ComfyUI 官方文档的说法,多图输入场景收益最明显,而这恰恰是参考图编辑最吃算力的地方。
对使用者来说,结论比机制简单:参考图编辑是大多数编辑管线里最昂贵的部分,而这个架构优化的正是这一段。
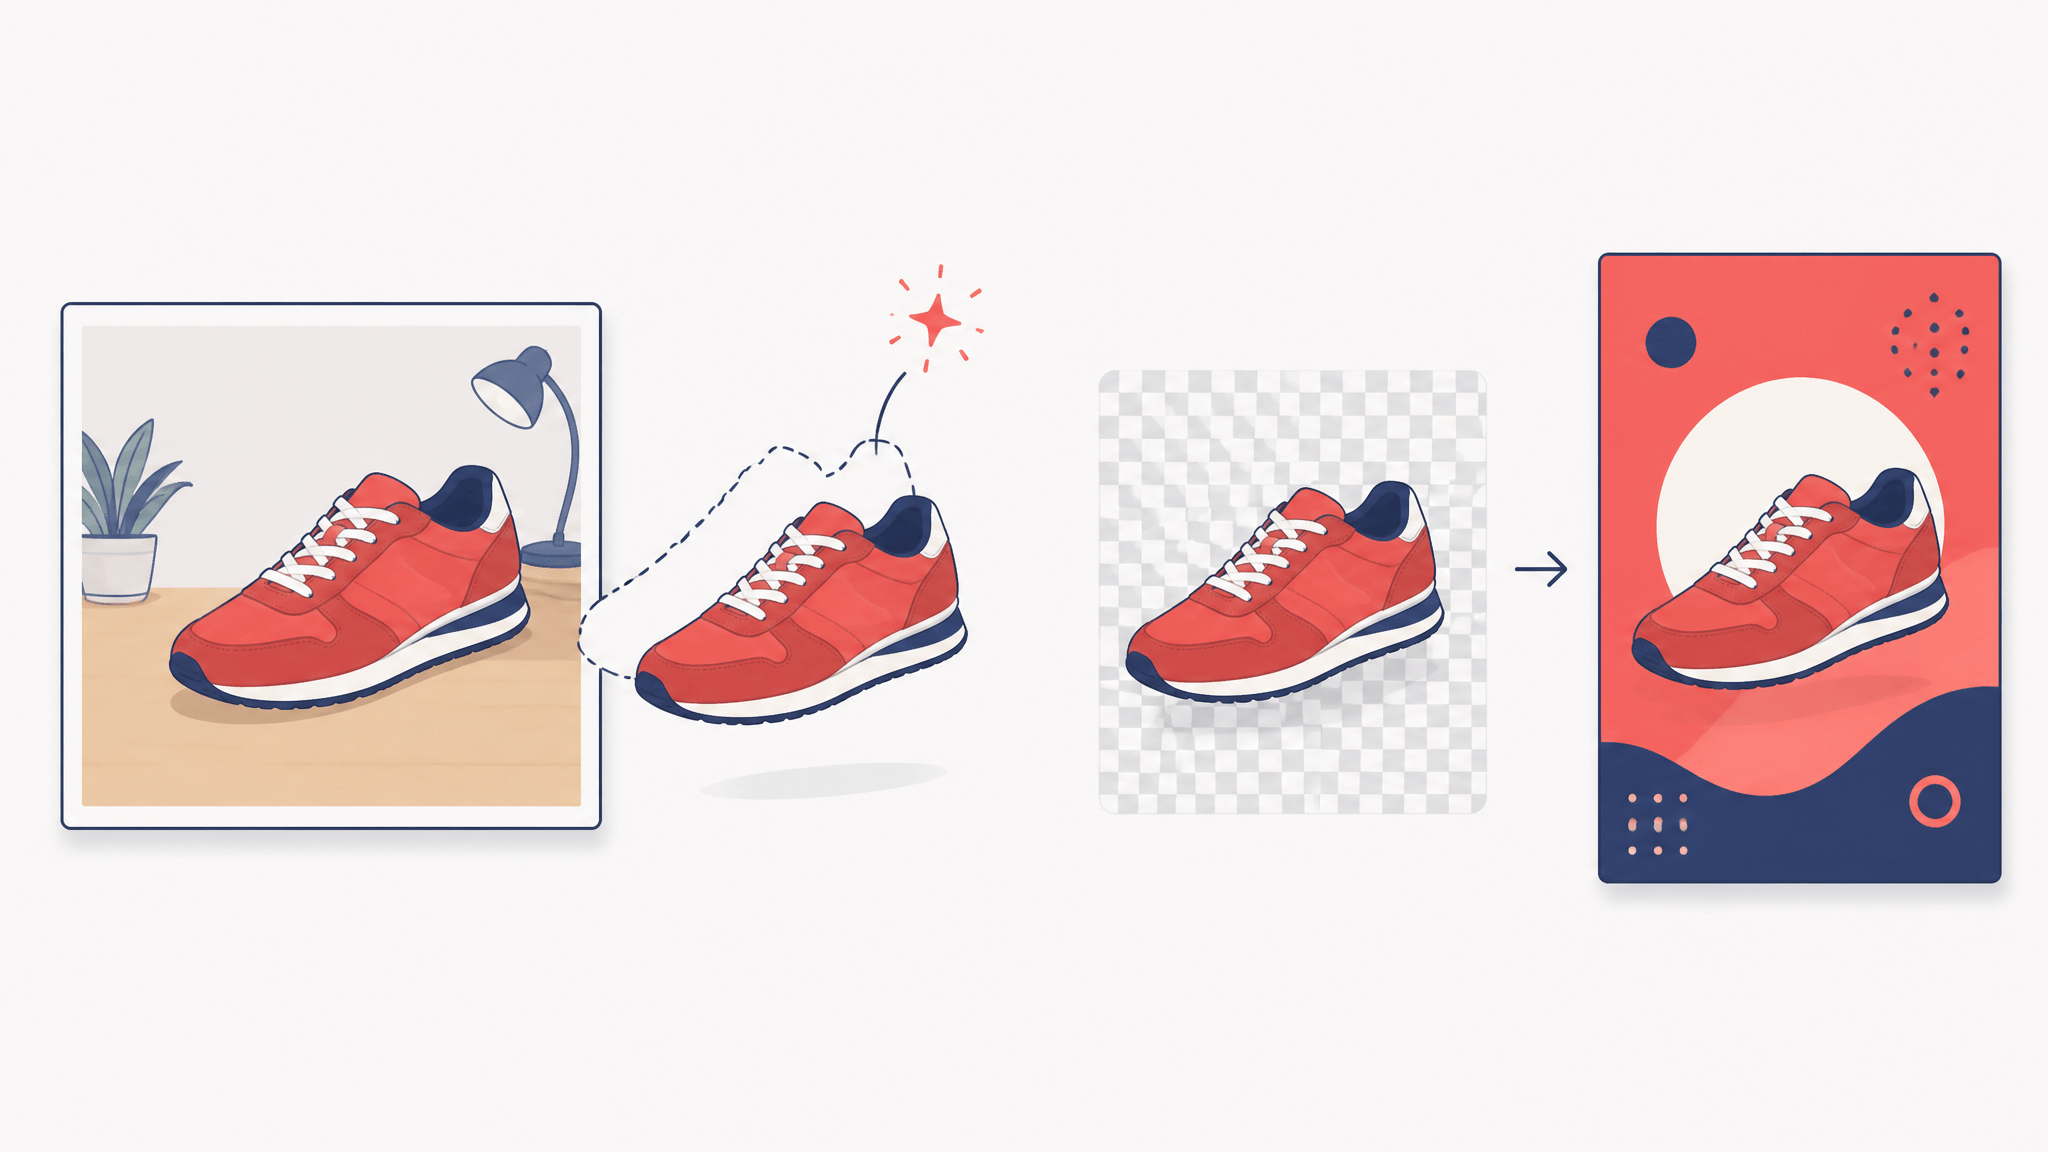
透明能力有三个方向:按提示词生成 RGBA、在透明图层内编辑、从普通照片中提取主体。
原生透明,从头到尾
透明能力是这次发布最有辨识度的部分,它体现在三个方向上:
按提示词直接生成透明图像。模型卡建议为 RGBA 输出使用明确的提示词格式——先告诉模型"This is an RGBA image with transparency",再描述主体,比如一个背景透明的卡通龙贴纸。对贴纸设计、营销素材,以及一切"先生成、再抠图"的合成工作流来说,这一步被直接省掉了。
**在透明图层内编辑。**因为透明是原生能力而不是事后附加,你可以在保持 alpha 通道完好的前提下编辑 RGBA 图像的内容——官方示例包括修改主体的表情,以及把透明图层里的文字换掉而背景保持透明。
**从真实照片中提取主体。**给模型一张普通 RGB 照片,它可以把主体提取成带透明通道的 RGBA 图层。抠图和素材准备,从此住在生成与编辑所在的同一个 checkpoint 里。
编辑工具箱:更多参考图,更精确的控制
编辑能力的提升可以按公告里的四个字来记:多、局、保、全——更多参考图、局部控制、保真、任务全面。
**最多 10 张参考图。**官方示例把六张人像合成一张合影,把模特、衣服、鞋、包、帽子五张图合成完整穿搭,还用十张家居图生成了一套室内布置。多主体、多素材的合成是最显眼的用法。
**三种圈定编辑区域的方式。**你可以在图上画不同颜色的圆圈并在指令中分别指认(官方演示里是"去掉蓝色圈的手表、把红色圈的头发改黑"),也可以涂抹标出区域,或者把原图与独立掩码作为两张图片分别输入——掩码方式能完整保留编辑区域之外的原始像素。
**保真是明确目标。**发布信息特别强调两件事:人像编辑前后面部特征保持稳定(身份一致性),以及商品放进新场景时文字、纹理、形态不走样。这些是官方公告声明的优化方向;在你的具体素材上表现如何,仍需要用自己的内容来验证。
**任务覆盖面广。**官方示例越过了常规编辑:从一张自拍生成可环视的全景图,把一张模特照扩展成信息量很大的信息图,再比如根据人物三视图生成分镜。
千问还宣称改进了文字渲染——不只是清晰度,还包括字体与排版——以及人物光影与细节。公告引用了 Qwen-Image-Bench 与其他开源、闭源模型的公开评测对比;我们没有独立验证这些分数,排名请当作厂商自己的展示,而不是定论。
今天就能上手的三种方式
**1. 零安装:官方在线 Demo。**千问在 Hugging Face 上运行官方 Demo Space,可以直接生成图像,或上传最多 10 张图片用文字指令修改。在安装任何东西之前,这是验证模型是否适合你的用例的最快方式。
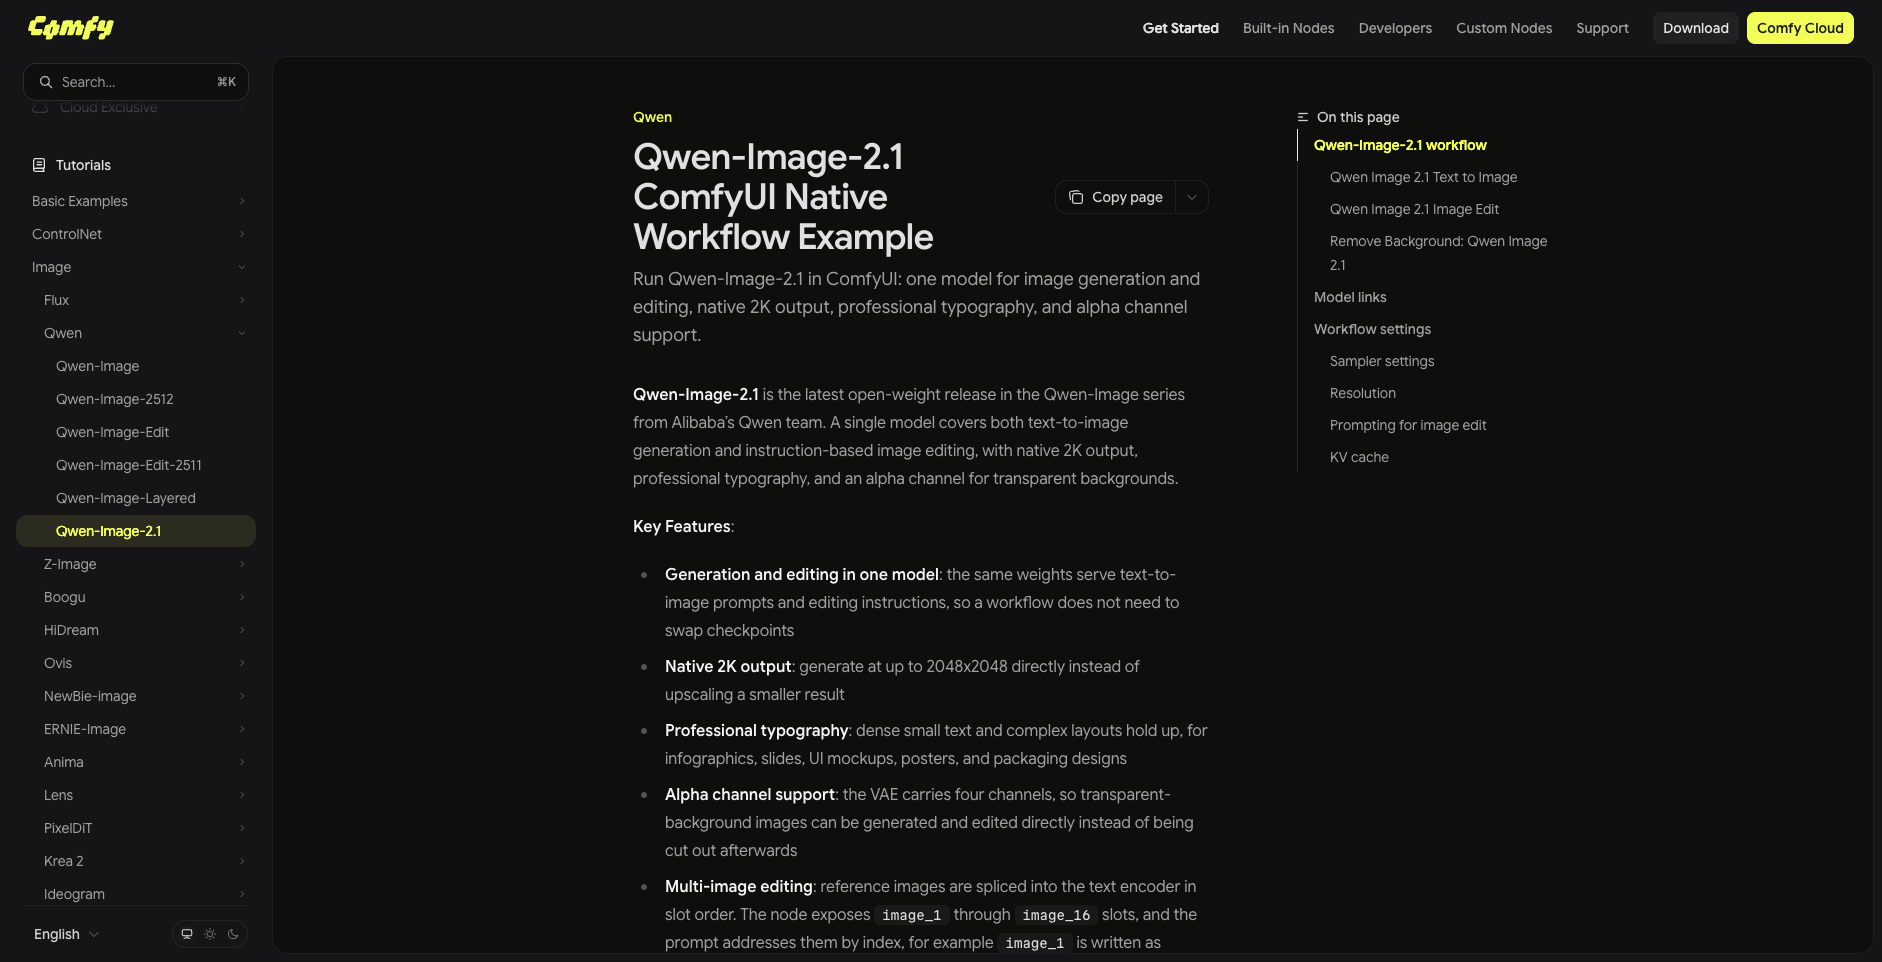
来源:ComfyUI 官方文档(docs.comfy.org),2026 年 9 月 22 日访问。
2. 本地工作流:ComfyUI。ComfyUI 官方文档提供了 Qwen-Image-2.1 的原生工作流,含三套模板:文生图、图像编辑和抠图(remove background)。文档强调了原生 2K 输出——直接生成最高 2048×2048 的图像,而不是先生成小图再放大——以及透明通道支持,编辑工作流还有专门的 KV cache 说明。
3. 代码:diffusers。模型卡为 diffusers 库提供了 QwenImage21Pipeline。文档示例使用 bfloat16 与 40 步推理,显存紧张时可以用 enable_model_cpu_offload()。模型卡列出的支持宽高比如下:
| 宽高比 | 分辨率 |
|---|---|
| 1:1 | 2048 × 2048 |
| 4:3 | 2400 × 1792 |
| 3:4 | 1792 × 2400 |
| 3:2 | 2528 × 1696 |
| 2:3 | 1696 × 2528 |
| 16:9 | 2752 × 1536 |
| 9:16 | 1536 × 2752 |
注意这些都是原生输出分辨率——2K 级别的工作不需要额外接放大器。
许可这一关:开放权重,受限使用
这是发布会报道最容易跳过的部分。权重以 Qwen Research License Agreement(2026 年 9 月 20 日发布)开源,条款对打算真刀真枪干活的人很重要:
- 许可只授予非商业用途——研究或评估——下的使用、复制、分发与修改。
- 商业用途需要向千问单独申请许可。
- 如果你用该模型或其输出去训练、微调或改进另一个对外分发的 AI 模型,必须在产品文档中显著标注 "Built with Qwen"(或 "Improved using Qwen")。
- 不能用"Qwen"作为衍生产品的主名称;"fine-tuned from Qwen Image"这类描述性表述是允许的。
实际含义是:研究者、折腾者和测试工作流的设计师可以放心上手;而要把权重接进付费产品的创业公司则不行——除非先拿到商业协议。"开放权重"和"任意免费使用"是两回事,对 Qwen-Image-2.1 来说,这个差别写在合同里,不是理论上。
自己跑权重还意味着自己准备 GPU、环境与维护。如果你的目标只是今天就用上千问驱动的图像编辑、又不想折腾本地环境,SketchTo 的 Qwen Image Edit 工具在浏览器里就能用,每次编辑 3 积分——它基于 20B 级的 Qwen Image Edit 模型而非 2.1,你可以在 2.1 生态(和它的授权选项)尘埃落定之前,先用它完成千问系的编辑工作。
现在适合谁上手
Qwen-Image-2.1 是千问第一个让生成、编辑、透明素材共享一个小型统一 checkpoint 的图像模型。如果你是研究统一图像模型的研究者、想要免切换 checkpoint 的透明与编辑能力的 ComfyUI 用户,或者工作流从头到尾都在跟 RGBA 素材打交道的贴纸、电商、合成方向设计师,这个组合是真正有用的。
如果你要把权重做进商业产品,许可条款就是决策点——在确定技术方案之前,先去申请商业授权条款。而如果你今天只需要在浏览器里完成靠谱的千问系编辑,那什么都不用安装。
无论选哪条路,方向已经清晰:图像 AI 的专用模型时代正在收敛为单个、高效、统一的 checkpoint——而透明度这个长期依赖手工后处理的环节,正在变成生成层面的原生能力。
分享
SketchTo 团队
专注 AI 工具、图像处理和创意工作流的技术写作者。
相关文章
AI 图像生成成本对比:20 个模型同一张图实际扣了多少
OpenRouter 用同一个提示词实测 20 个图像模型并记录每一笔账单——同样一张 1:1 图片,$0.006 到 $0.134,价差 22 倍。看真实单张成本,以及怎么按预算选模型。
GPT-6 Astra 真实用例盘点:图像与设计工作里哪些是真的
按出处梳理 GPT-6 Astra 在图像与设计方向的真实用例——3D 世界、前端设计、媒体制作——以及它还不领先的短板和可用性、成本、耗时的现实约束。
GPT-6 Astra 前端设计能力 vs 专用草图工具:通用模型能替代专用工具吗
GPT-6 Astra 能把草图变成可运行 UI,还能跑前端 QA。本文按交付物、耗时、计费、可控性与可用性,对比通用电脑操作模型与专用草图转渲染流水线,并给出按交付物选择的决策框架。