在 ComfyUI 里用 MOSS-Image 做指令式改图:按文档搭一遍
MOSS-Image 可以在 ComfyUI 里做指令式改图,但光靠底模不行。 MOSS-Image 本身是文生图模型,没有图像输入;改图能力来自社区训练的 edit LoRA,它把你的照片编码成 reference latent 送进采样器。你需要 ComfyUI 0.43.0 及以上、内置的「Text Encode MOSS-Image Edit」节点,以及与该 LoRA 训练布局一致的 edit_format。最后这一项 ComfyUI 文档写得很直接:填成别的值照样会出图,但人脸、构图和细节会相对原图漂移。
这篇按官方 ComfyUI 教程、OpenMOSS 仓库和两张 LoRA 模型卡把整条路径写清楚:改图到底改了什么、要下哪几个文件、模板怎么跑、指令怎么写、哪些参数决定原图保不保得住。文中不包含本机实测的画质或速度数据。
关键结论
- MOSS-Image 是 OpenMOSS 的 5B 开源文生图与版式模型,2026-10-16 发布 Base 与 SFT 两个 checkpoint。
- 指令式改图在 2026-10-22 才出现,来自社区 rank-64 edit LoRA;ComfyUI 主干在同一天合并了对这类适配器的原生支持。
- 改图模板要求 ComfyUI 0.43.0+,文生图模板要求 0.42.0+。
- 按 int8 计,模板权重约 13 GB,另加 297 MB 的 edit LoRA。
- 每个 edit LoRA 只对应一种训练布局,内置模板用的是 chinoll 那一套。
所谓「MOSS-Image 改图」到底是什么
MOSS-Image 是 FLUX.2 latent 空间里的单流 DiT,配 Qwen3.5-9B 文本编码器。它擅长渲染中英文文字、能接受约 4K token 的长提示,也支持用 JSON 版式按 bounding box 摆放元素和文字块。ComfyUI 在发布当天就通过 PR #17095 合并了原生支持,所以标准路径不需要装插件。
它没有的是图像输入。ComfyUI 官方教程写得很直白:参考图最多进到 prompt enhancer,进不了扩散模型。在 edit LoRA 出现之前,这留下两种「编辑」:改 layout JSON 重新生成,或者把照片送进 color/depth control adapter。两者都换不了一件外套。
2026-10-22,chinoll/Moss-Image-Edit 出现在 Hugging Face:基于 MOSS-Image Base 与 SFT 训练、rank 64。同一天,ComfyUI 主干合并了 PR #17296,加入 Text Encode MOSS-Image Edit 节点,并为 ai-toolkit 格式的 edit LoRA 补上 key 别名,让它们能用原生 LoRA Loader 加载。这次合并晚于 v0.42.1,所以改图模板要求 0.43.0+。
机制解释了后面所有参数。参考图先被 VAE 编码成 latent token,按自己的 RoPE 位置、在 timestep 0 追加到图像序列后面,彼此之间互相关注。这些 token 在整个采样循环里不变,所以它们的 attention key/value 会被缓存,而不是每一步重算。文本编码器负责读你的指令;它是否也能看到参考图,取决于你声明的布局。
| 原生指令编辑模型 | MOSS-Image + edit LoRA | |
|---|---|---|
| 图像输入 | 模型自带 | 只能通过 LoRA 的 reference latent |
| 指令理解在哪 | 训进底模 | 训进一个小型社区适配器 |
| 支持状态 | 厂商维护 | ComfyUI 核心节点,标记为实验性 |
| 布局要求 | 除厂商自有接口外没有额外要求 | 参考图必须匹配适配器的训练布局 |
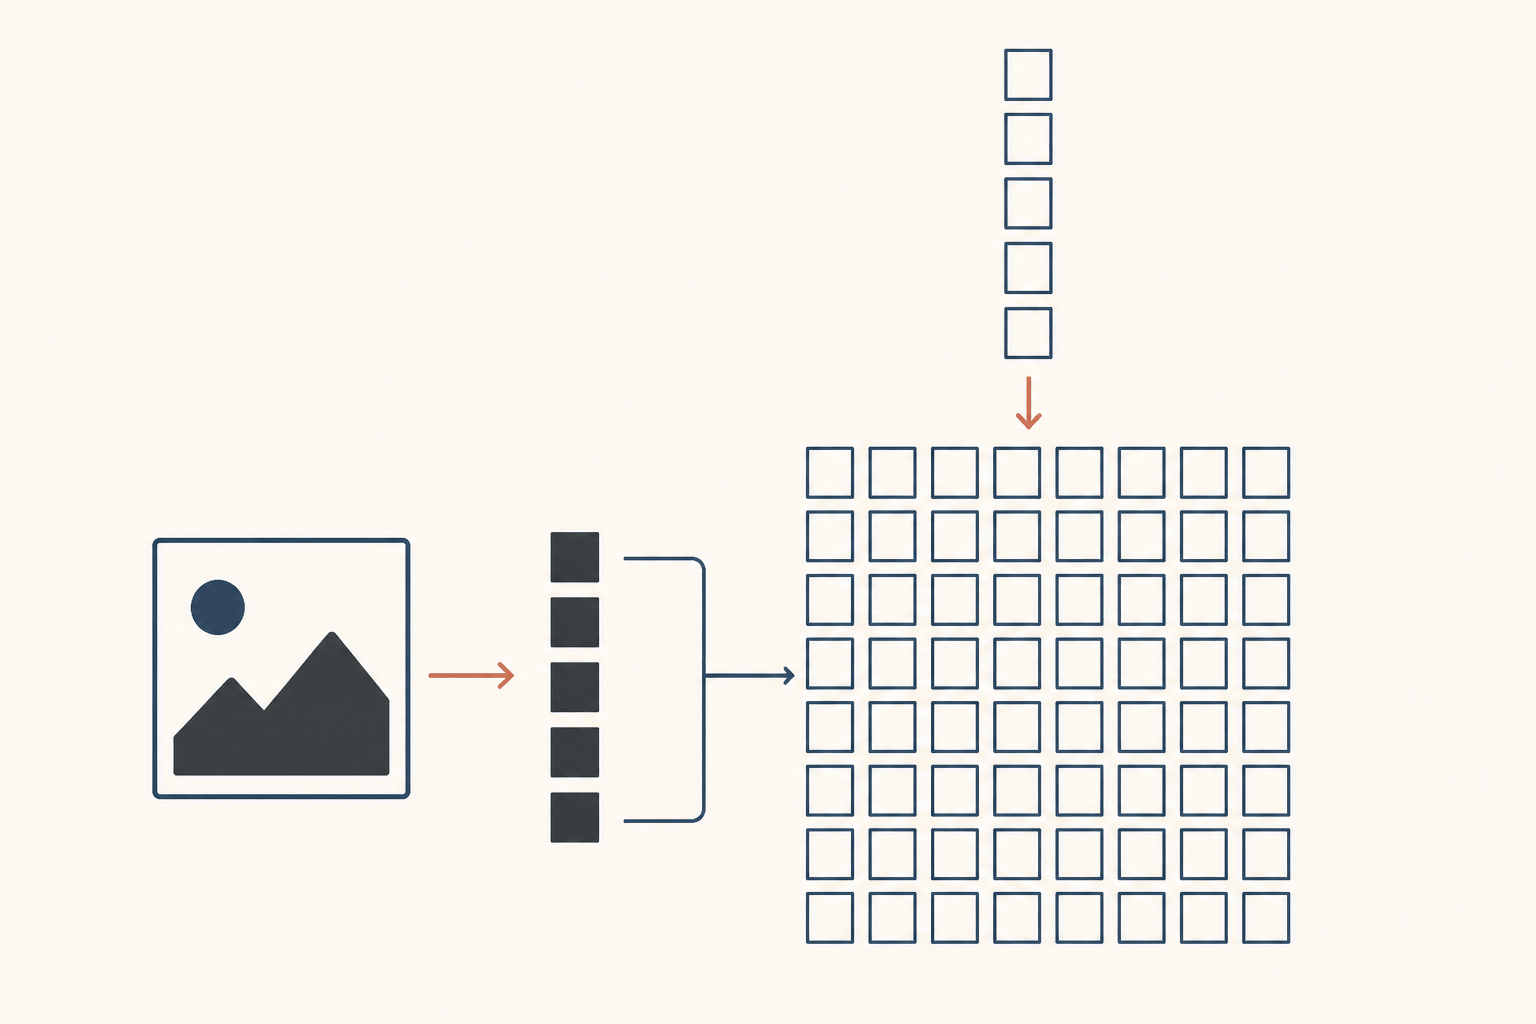
按 ComfyUI MOSS-Image 文档描述绘制的示意图,非截图。
开始之前要准备什么
两件事决定后面的步骤是否成立:
- ComfyUI 0.43.0 或以上,用于改图和 color/depth control 模板。
- ComfyUI 0.42.0 或以上,如果你想先用文生图模板对比底模输出。
权重都在 Hugging Face 的 Comfy-Org/MOSS-Image。下表是仓库里的真实文件大小,先算好磁盘和内存再下:
| 文件 | 目录 | 大小 | 用途 |
|---|---|---|---|
moss_image_sft_int8_convrot.safetensors |
models/diffusion_models/ |
5.41 GB | 改图模板加载的 SFT checkpoint |
qwen3.5_9b_w4a8_gptq.safetensors |
models/text_encoders/ |
7.34 GB | 文生图与改图模板的文本编码器 |
flux2-vae_small.safetensors |
models/vae/ |
249 MB | VAE |
moss_image_edit_lora_rank_64_bf16.safetensors |
models/loras/ |
297 MB | edit LoRA |
合计约 13 GB,还没算推理时的激活占用。bf16 版本(moss_image_sft_bf16 10.16 GB、qwen3.5_9b_bf16 19.3 GB)会多占约 16 GB 磁盘换内存余量;除非你确定显卡够宽裕,第一次先下 int8 这一套更省事。ComfyUI 教程把权重的许可写作 Apache 2.0。
下载文件
走模板的话,放置位置不用自己记:
- 把 ComfyUI 升到 0.43.0 以上并重启。
- 打开 Workflow → Browse Templates,搜索 MOSS-Image: Image Edit。
- 按模板提示下载缺失模型,或者自己按上面四个目录放好。
- 在 Load Image 里放照片,正向提示只描述「要改的那一处」。
想用命令行也可以,LoRA 模型卡给了等价的 hf download 命令:adapter 文件放进 Moss-Image-Edit 目录,供 Diffusers 风格的插件路径读取;单文件模板路径只需要把 .safetensors 放进上面四个文件夹。这里有两个容易弄错的地方:
- 插件时代的工作流不能只换 loader 就接着用。 原生模型用的是不同的 timestep multiplier,OpenMOSS 的 README 建议直接导入原生工作流,并且不要把原来的
ModelSamplingSD3带过去。 - 文本编码器必须是 w4a8 那个版本(文生图和改图模板都如此)。改用 int8 编码器的是 color/depth control 模板,别搞混。
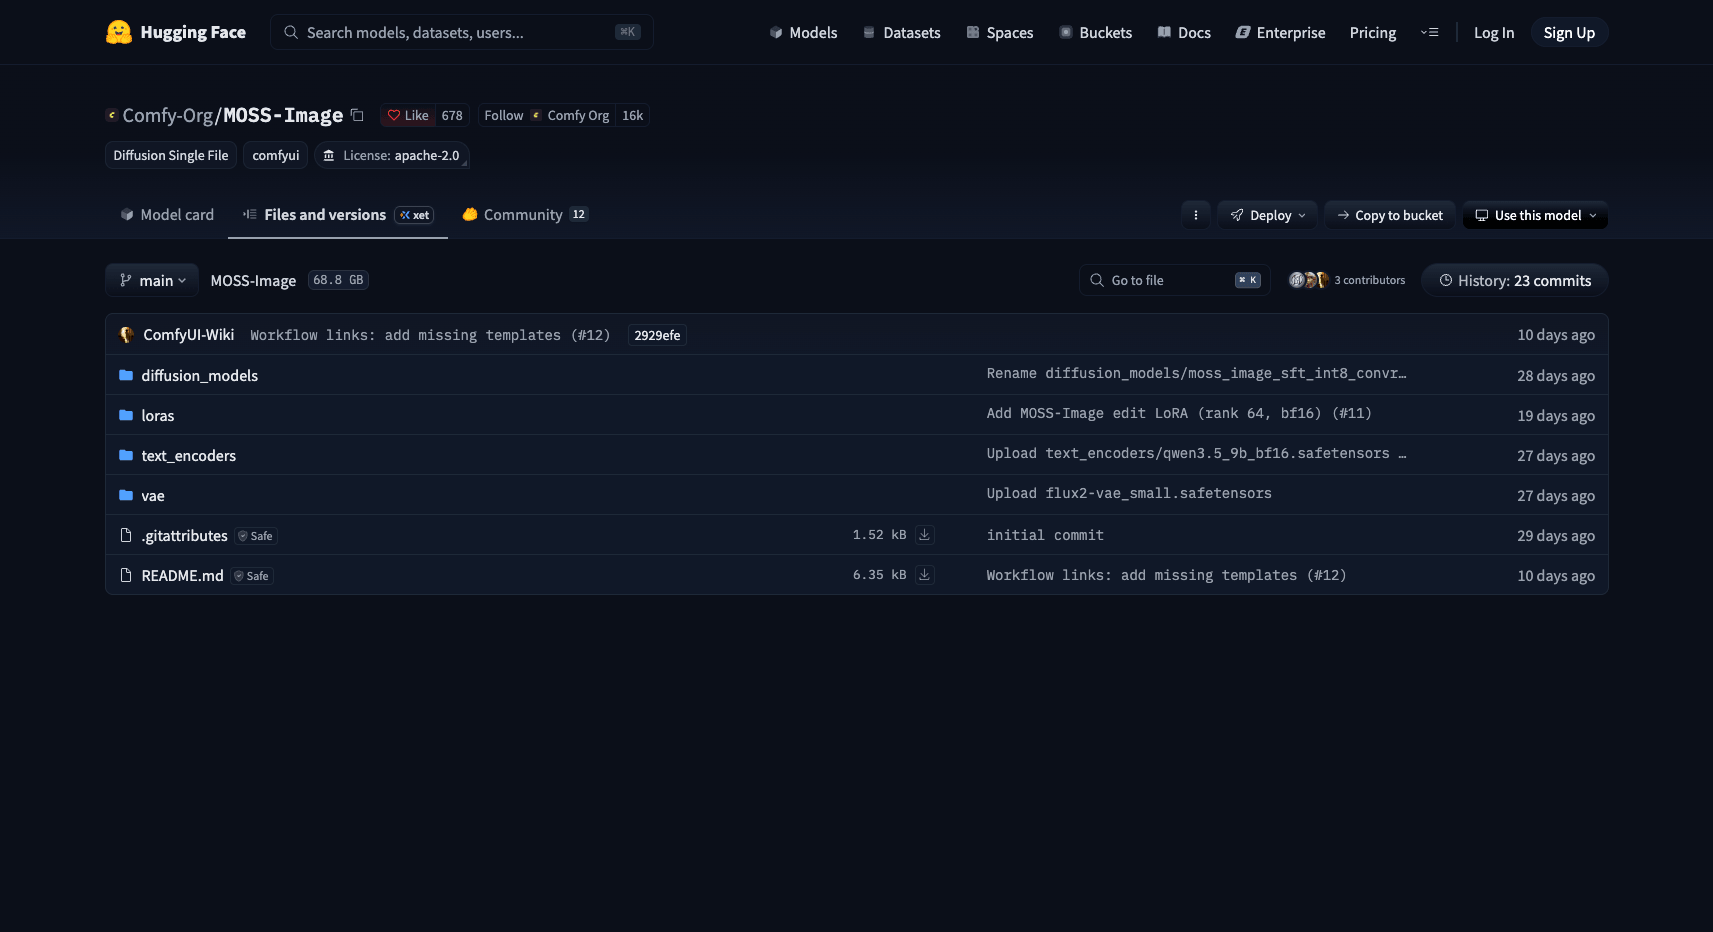
Hugging Face 上的 Comfy-Org/MOSS-Image 仓库根目录(2026-11-14 访问)。本文用到的四个文件合计约 13 GB。
跑内置的改图模板
改图图就是普通 MOSS-Image 图加两处改动:
- Load Diffusion Model 加载 SFT int8 checkpoint。
- LoRA Loader 加载
moss_image_edit_lora_rank_64_bf16.safetensors。 - CLIPLoader 以
moss_image类型加载qwen3.5_9b_w4a8_gptq;Load VAE 加载 FLUX.2 small VAE。 - Text Encode MOSS-Image Edit 跑两次——正向指令一次、负向一次,两边接同一组参考图。
- 采样、解码、保存。模板会把照片缩放到约 1.0 MP,保持长宽比。
这五步里有两处容易出错。参考图按传入尺寸使用,接之前先缩到 1 MP 左右,否则就是白付 token 成本。image_strength 只控制文本编码器看图的权重(ai-toolkit 布局,或没接 VAE 时);设成 0 指令就不看参考图了,大于 1 则会过度强调。
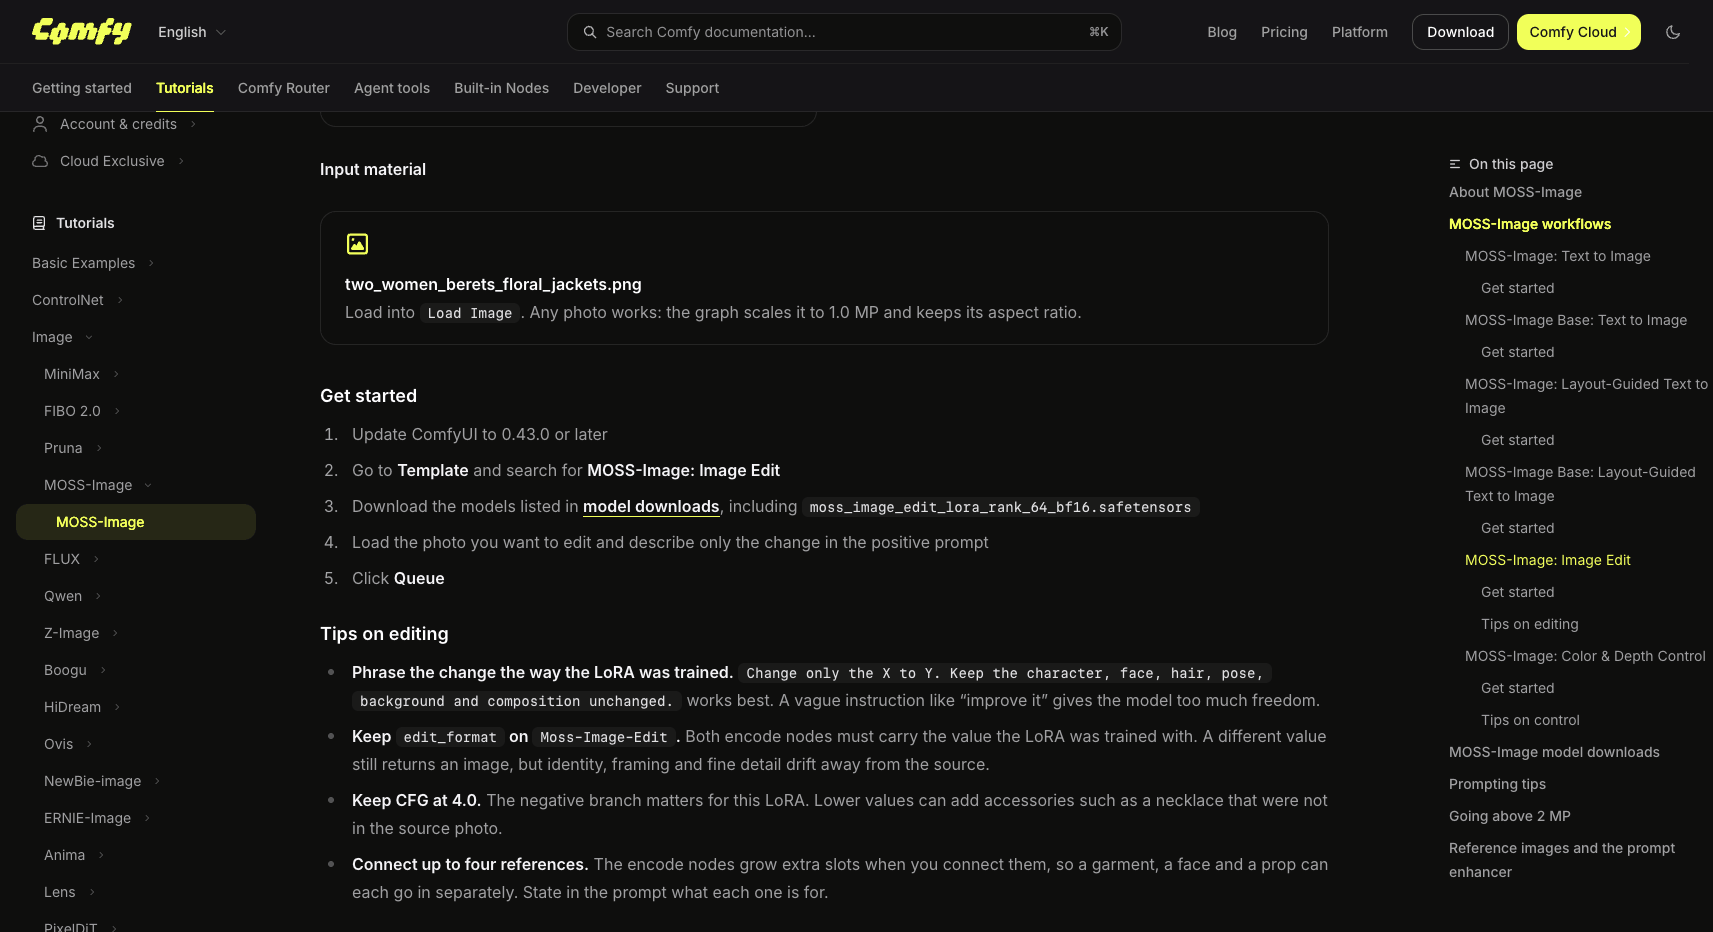
ComfyUI 文档,MOSS-Image 教程(2026-11-14 访问)。
指令怎么写
这个 LoRA 训练时的指令形态很窄,模型卡和 ComfyUI 的提示说法一致:说出要改的那一处,然后明确把其余部分保护起来。
Change only the jacket to a black leather biker jacket. Keep the character, face, hair, pose, background and composition unchanged.
同一句式换个场景:
Change only the lighting to warm late-afternoon sun from the left. Keep the face, hair, clothing, pose and background unchanged.
Change only the background season to winter with light snow. Keep the character, outfit, pose and framing unchanged.
「improve it」「make it better」这类模糊指令等于放任模型重画整幅图。接多张参考图时,要在指令里说明每张图的作用——适配器自己不区分角色,节点上的槽位会随连接增加,最多四张。官方文档给的例子是「让图 1 的人穿上图 2 的衣服」。
真正决定结果的参数
| 参数 | 取值 | 原因 |
|---|---|---|
edit_format |
用 chinoll 的 LoRA 填 Moss-Image-Edit;用 MOSS-Image-Edit-HQ 填 ai-toolkit |
决定 reference latent 的布局,以及文本编码器是否看得到参考图。填错照样出图,但人脸、构图和细节会漂。 |
| CFG | 改图模板保持 4.0 | 这个 LoRA 依赖负向分支。值偏低会凭空加出原图没有的配饰。 |
| 步数 / 采样器 | 模板是 25 步、CFG 2.5、er_sde;官方观感是 50 步、CFG 3、Euler |
模板为速度调过,官方 Base 设置更慢更干净。 |
| 输出尺寸 | 建议 1–2 MP,且是 16 的倍数 | 模型可从约 0.25 MP 外推到 4 MP,超出 1–2 MP 质量会掉。 |
| 参考图尺寸 | 接节点之前先缩放 | 每张参考图都按传入尺寸使用,尺寸越大,每一步要处理的 token 越多 |
| SLG | 打开,第 22 层 | 关掉可能更「真实」,但细节容易塌。 |
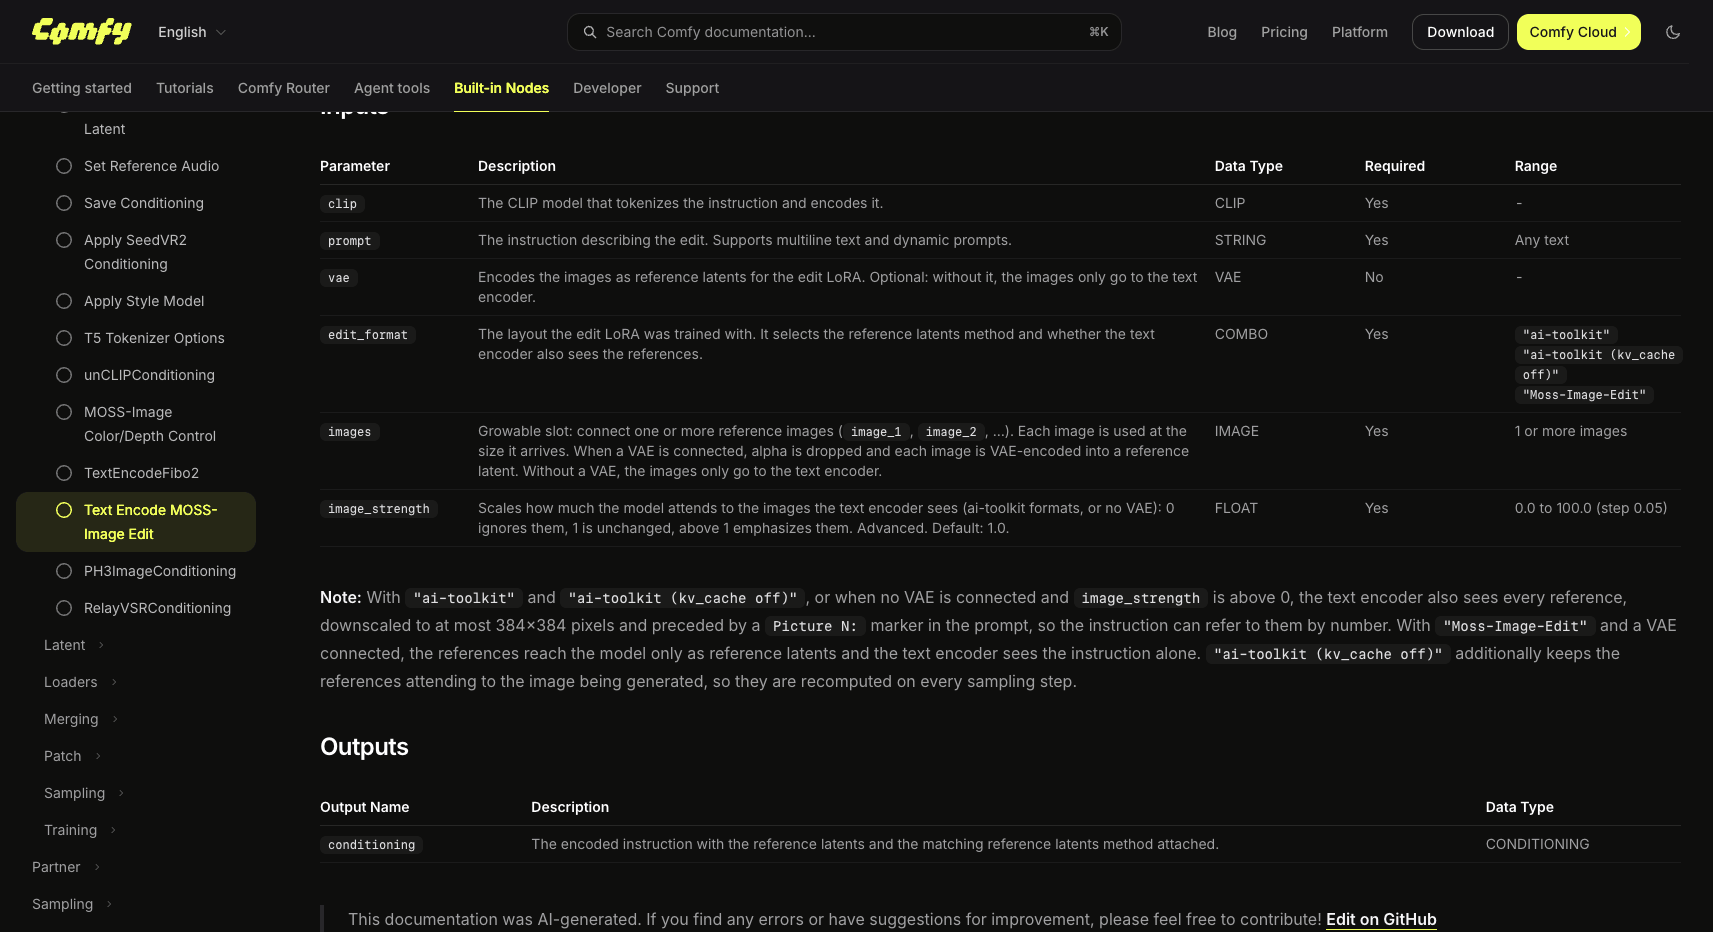
ComfyUI 内置节点文档(2026-11-14 访问)。
选哪一个 edit LoRA
目前主流的是两个社区方案,互不通用:
chinoll/Moss-Image-Edit:rank 64,Base 与 SFT 都支持,1–4 张参考图,面向颜色、服装、光线、季节和风格。ComfyUI 的核心支持就是围绕这套布局实现的,内置模板也用它。这个布局下文本编码器拿不到参考图,所以指令必须自己把意图说全。akhaliq/MOSS-Image-Edit-HQ:MOSS-Image-SFT 的非官方微调,推荐armV5,ai-toolkit 格式。卡片建议 50 步、CFG 3.0、Euler、SLG 第 22 层,也如实写了代价:结果可能比原图更饱和,多参考图合成不是它的训练目标,Base/Kromoss 兼容性未经验证。
另外还有一个社区 8 步 DMD 蒸馏 LoRA,可以叠在 edit LoRA 后面(两者强度各 1.0、8 步、CFG 1)。卡片说大约快六倍,也说得很清楚会变软:加物体变弱、颜色约束变差。适合草稿迭代,定稿仍回到 50 步。
还有第三条路:Chenkin-x 插件自带 Diffusers 快照,默认 512×512、30 步、CFG 4.0、参考图长边 512。装了它就是在跑另一张图、另一套默认值,别把它和原生模板的参数混着用。
排错对照
| 现象 | 多半是 | 怎么修 |
|---|---|---|
| 指令已经写得很明确,人脸或构图还是变了 | edit_format 和 LoRA 训练布局不一致 |
chinoll 的 LoRA 填 Moss-Image-Edit,HQ 填 ai-toolkit,两个编码节点都要改 |
| 改动几乎没生效 | 步数太少或 CFG 偏低 | 往 50 步、CFG 3.5–4 靠(ai-toolkit 系),确认 LoRA 强度是 1.0 |
| 冒出原图没有的配饰 | Moss-Image-Edit 布局下 CFG 低于推荐值 | CFG 保持 4.0 |
| 小改动却整幅变样 | 指令要求的东西太多 | 改写成「只改 X,其余保持不变」 |
| 结果发软、发灰 | 定稿用了 8 步加速栈 | 去掉加速,用 edit LoRA 单独跑 50 步 |
| 参考图完全没起作用 | 没接 VAE,或 image_strength 为 0 |
接上 VAE 生成 reference latent;把 image_strength 提到 0 以上 |
什么时候不该在本地跑 MOSS-Image 改图
如果你本来就在用 ComfyUI、想要本地控制,而且改动正好落在 LoRA 训练过的范围内(服装、颜色、光线、季节、风格),这套方案很合适。下面任一条成立就不合适:
- 你没有约 13 GB 权重和相应显存。 int8 让消费级显卡勉强可行,但文本编码器占了大头。
- 你需要合成或从另一张照片搬物体。 架构最多接四张参考图,可现有 LoRA 都是按单参考图编辑对训的;HQ 的卡片直接说合成不是它学到的东西。
- 你需要官方编辑模型。 截至现在 OpenMOSS 没有发布编辑 checkpoint,底模根本没有图像输入。
- 你只需要浏览器,不需要显卡。 如果重点是「把这张图改掉」,本地栈就是额外成本——托管模型也能做指令编辑,SketchTo 上的 Qwen-Image-Edit 就是其中之一;它是另一个模型,有自己的强项,不是 MOSS-Image 的移植版。
结论
要在本地用 MOSS-Image 改图,先接受它本质上是文生图模型:编辑能力来自社区 edit LoRA 和 reference latent。把版本升到 0.43.0+,下载四个文件(int8 约 13 GB),先选 LoRA 再把 edit_format 对齐,然后用「只改一处、其余不变」的句式写指令。文档记录的失败方式就是这几步配置,而不是模型本身。
分享
SketchTo 团队
专注 AI 工具、图像处理和创意工作流的技术写作者。
相关文章
Sheru Bhai 提示词:怎么做出「和狮子合影」的那张照片
Sheru Bhai 提示词拆解:一段固定的角色描述、三段可直接复制的场景提示词、完整操作步骤,以及脸不像、爪子糊、角色漂移这三种失败的对症改法。
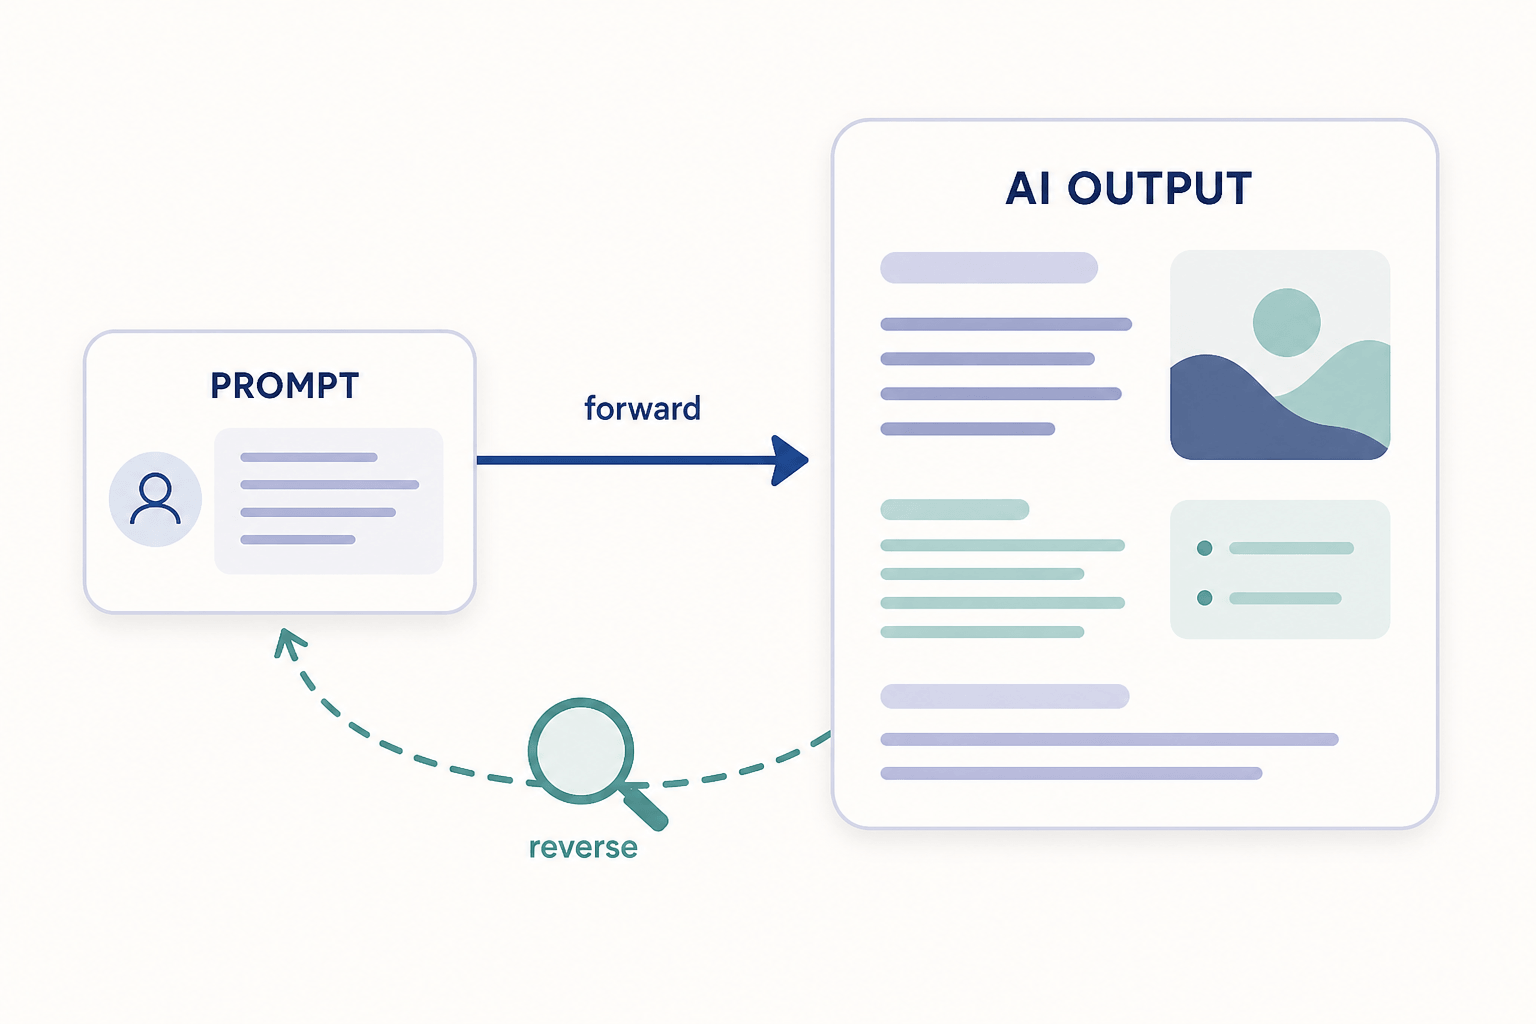
逆向提示词工程是什么?定义、做法与适用边界
逆向提示词工程(reverse prompt engineering)指只分析 AI 输出,倒推它背后最可能的提示词。本文整理研究者记录的完整方法、今天就能用的手工清单,以及这套技术在哪里可靠、哪里失效。
AI手办提示词怎么写:可复制的prompt模板与免prompt捷径
一套能直接粘贴到 ChatGPT 或 Gemini 的 AI 手办 prompt——包装、配件、底座、姿势逐项讲清怎么写,附真实效果预期和免 prompt 的生成器捷径。