逆向提示词工程是什么?定义、做法与适用边界
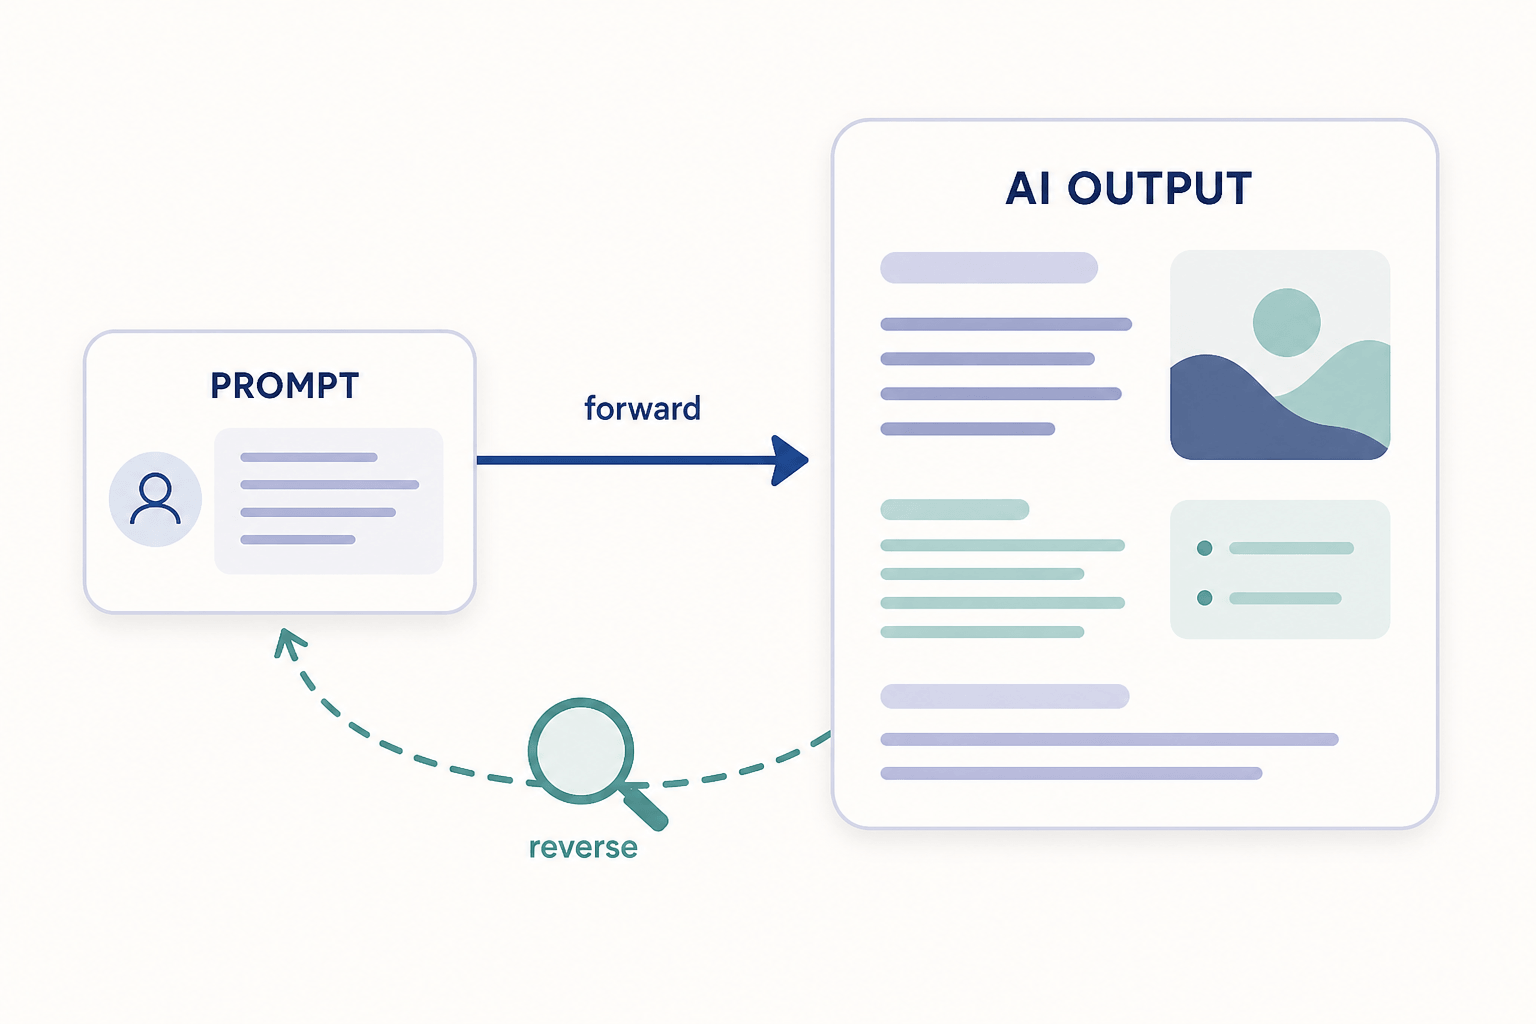
你看到一段 AI 生成的内容——一个故事、一份摘要、一条结构完美的回答——然后想知道它背后用了什么提示词。把这件事倒过来做,就是逆向提示词工程(reverse prompt engineering,RPE)。一句话定义:逆向提示词工程是只分析 AI 的输出,去推断最可能生成它的提示词,全程不需要接触模型内部信息。
这件事值得认真对待,因为提示词几乎总是隐形的。文章、产品页、学习笔记、社交帖子里,越来越大比例的内容出自语言模型之手,而塑造这些内容的指令本身却看不到。逆向提示词工程把这条隐藏指令变成一个可以学习的猜测,而且研究者已经把这套方法形式化到只需五条文本输出就能运作的程度。
要点速览
- 逆向提示词工程(RPE)只凭输出本身重建提示词——不需要接触模型内部信息。
- 学术界记录的方法是迭代式的:生成候选提示词、把它们的输出与原始输出比对、不断修正。已发表的一个框架用受遗传算法启发的循环完成这一过程,且无需训练模型。
- 你今天就能用更轻量的手工版本:按固定清单逐项分析——格式、受众、假设、语气、领域知识,再写出候选提示词和备选提示词。
- 这套方法对自然语言文本最有效;想推断一张生成图片背后的提示词,可靠性低得多。
提示词工程 vs 逆向提示词工程
两者是同一项技能互补的两面。常规提示词工程是建构:搭一个提示词去得到想要的输出;逆向提示词工程是解构:从已有输出出发,推断背后的问题是什么。
| 维度 | 提示词工程 | 逆向提示词工程 |
|---|---|---|
| 起点 | 一个想让 AI 完成的目标或任务 | 一段已有的 AI 输出 |
| 目的 | 设计出能产出理想结果的提示词 | 推断某个结果背后的提示词或推理 |
| 典型用途 | 生成内容、解决问题 | 排障、学习、分析、改进提示词质量 |
| 思维方式 | 建构式:"我该问什么?" | 分析式:"背后多半问了什么?" |
因为很多不同的提示词都能把模型引向相近的输出,任何一次重建都只是强有力的假设——不是找回了什么秘密。
研究者如何重建提示词
这套技术的正式版本来自语言模型反转(language model inversion)研究。Li 和 Klabjan 2024 年的论文提出了一个免训练框架,只利用少量文本输出、在严格黑盒条件下重建提示词——不碰 logits、不碰权重、不碰系统提示词。下文的方法步骤依据 Learn Prompting 对该框架的分步讲解整理;需要说明的是,这是对已记录流程的介绍,并非我们自己的实测报告。
问题设定:同一条隐藏提示词让模型生成若干条输出,目标是只凭这些输出重建出它的近似版本。方法随后经过四个阶段逐步改进。
1. 一条输出,一次猜测。 最简单的做法是从单条输出推断提示词,但通常过拟合。Learn Prompting 给出的例子里,隐藏提示词要求列出"三个常见的创业挑战",模型回答"Funding, hiring, and scaling"——而仅凭这条输出重建出的提示词变成了"客户服务与网络安全领域有哪些创业挑战?",凭空多出了原文没有的细节。
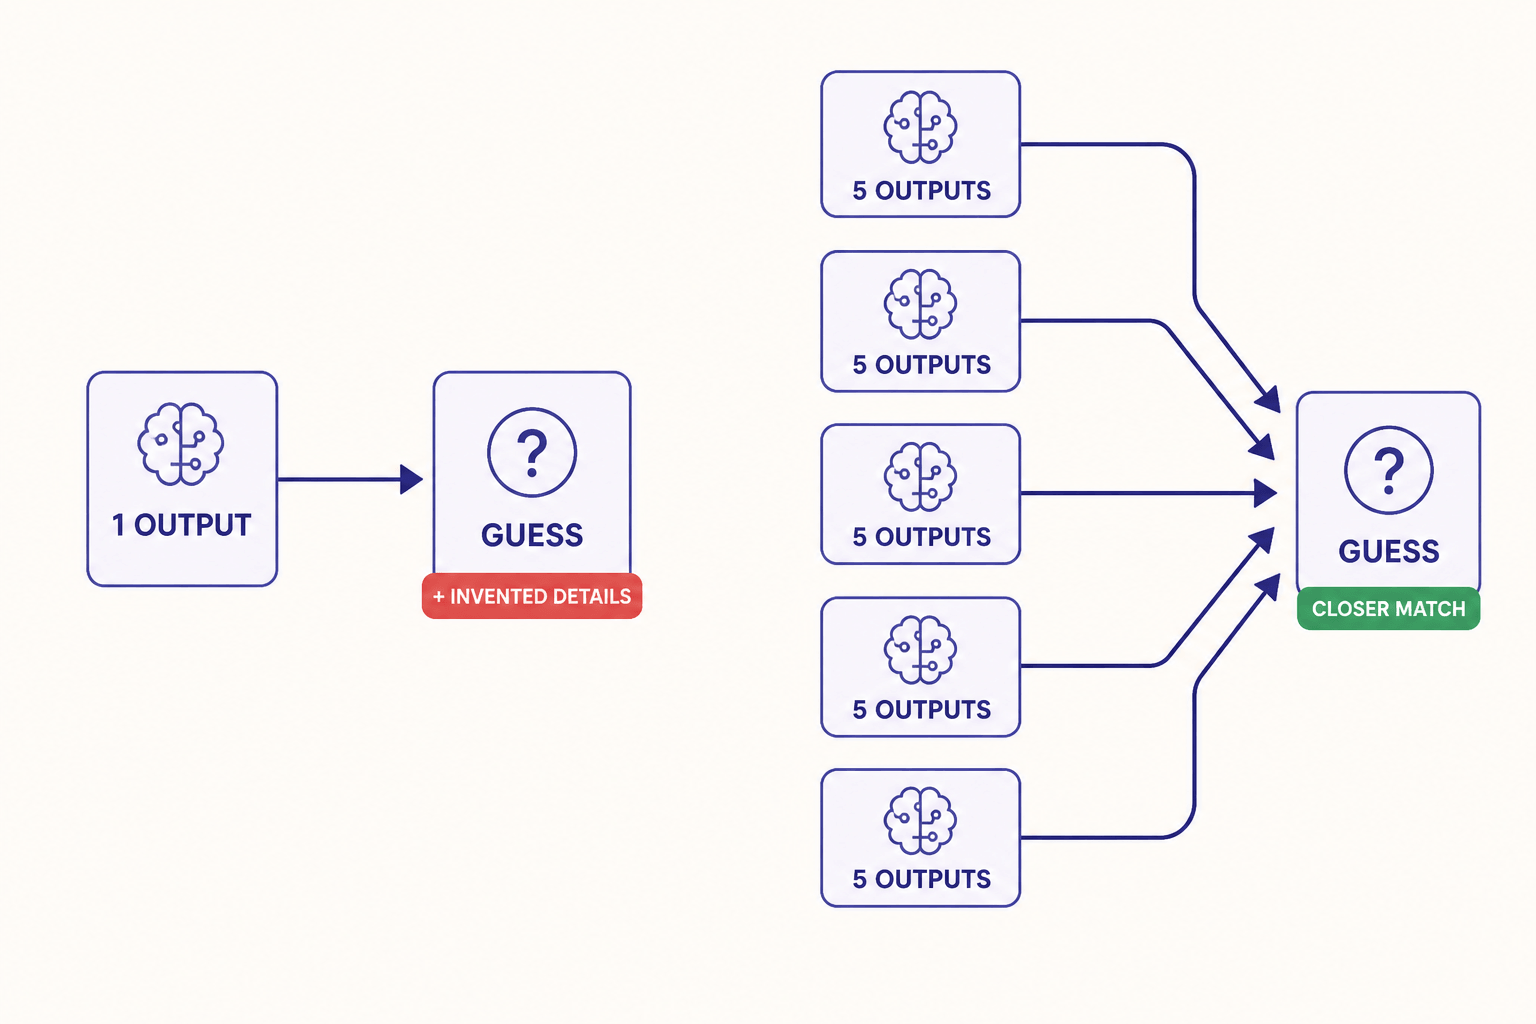
2. 五条输出,一次猜测。 让同一条隐藏提示词多跑几次,把所有输出放在一起推断。随机性让每次输出略有差异,但重合的部分会指向提示词真正的要求。基于五条输出的重建落在了"What are three startup challenges?"——与原意接近得多。
3. 五条输出,五个候选。 不再押注单次猜测,而是生成多个候选提示词,再从中择优。比较是机械的:让每个候选生成新输出,用与原始输出的词重合度(ROUGE-1)决定胜负。
4. 迭代精修(RPEGA)。 完整框架把这些步骤包进一个受遗传算法启发的优化循环:从候选提示词出发,生成输出、对照原始输出打分、改写最优候选的措辞,然后重复。每一轮都让重建的语义更贴近原始提示词。
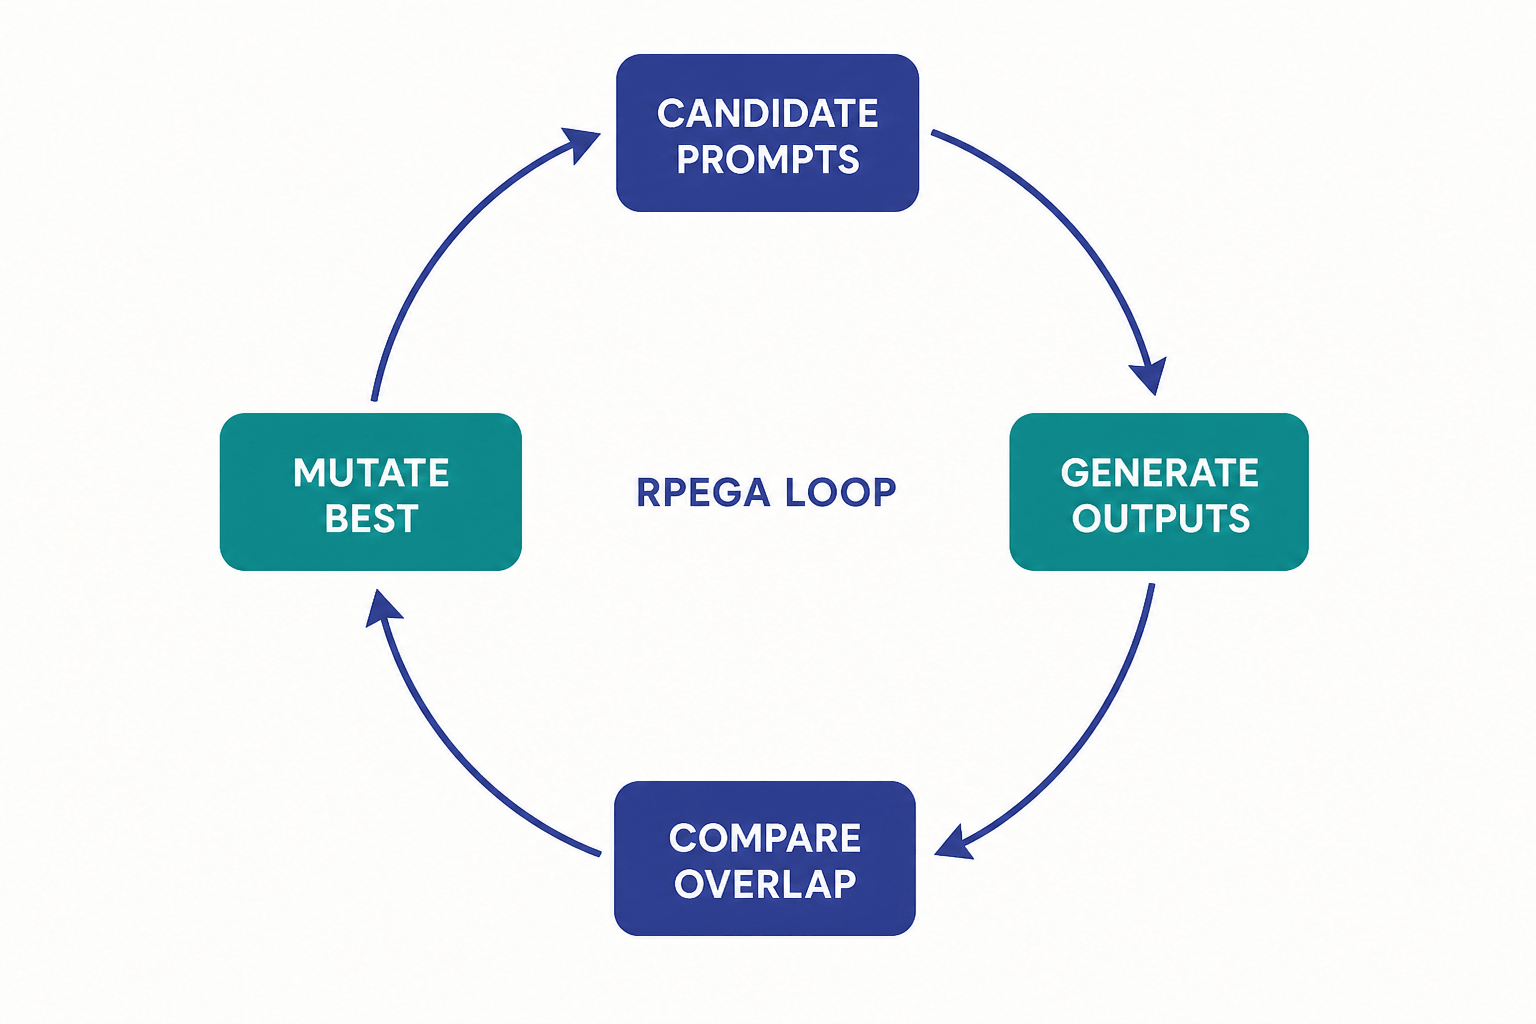
这个方法的特别之处在于它不需要什么。早期的模型反转方法依赖 logits 这类内部信号,或依赖大量成对的示例输出;RPE 框架两者都不需要,也不涉及任何模型训练——这正是它能直接用于闭源商业模型的原因。
今天就能用的手工方法
想有效地倒推分析,并不需要优化循环。对常见内容——文章、手册、术语表——实操者用的是一套结构化阅读法。tcworld 杂志发表过一份清单,把它压缩成七个问题,接着就能变成一段短流程:
- 判断输出的格式(手册、术语表、故事、流程说明、API 文档)。
- 从用词和默认知识推断目标受众。
- 列出内容对读者做出的假设。
- 记录语气与风格——平实、正式、俏皮、克制。
- 问自己内容默认了哪些领域知识。
- 起草最可能产出这段输出的提示词。
- 再写一条能产出相似结果的备选提示词——这能让你对不确定性保持诚实。
一份可复用的分析提示词模板,方括号为变量,改编自该文章中的实战示例:
You are analyzing an AI-generated output. Given the following [OUTPUT],
infer: the likely prompt that produced it, the intended audience,
the tone and formatting conventions used, and any domain knowledge
the prompt must have requested. Then propose one alternative prompt
that could plausibly produce a similar result, and state which
details of your inference are uncertain.
最后一句是关键。它强迫模型(也强迫你)把有把握的推断和纯粹的猜测分开——这正是手工逆向分析需要的纪律。
人们用它做什么
已记录的用途集中在三类:
- 安全与对抗研究。 弄清一条隐藏提示词能做什么,有助于研究者评估漏洞——系统可能被诱导透露或执行什么。
- 提示词找回与优化。 当某个输出确实出色,重建它背后的提示词,就能复用、微调这条指令,迁移到相近任务上。
- 向优秀内容学习。 解构一篇出色的文章或文档,能暴露它背后的指令模式——受众、结构、语气——反过来打磨你自己的提示词。
图片提示词能逆向吗?
简短回答:不可靠,而且资料来源对这一点毫不讳言。tcworld 的分析明确写道,RPE 对自然语言最有效,而推断一张生成图片或一段复杂代码背后的提示词"投机性要大得多",需要深厚的领域知识和对模型能力的假设。
原因在结构层面。文本模型的推理过程就写在输出里;图像模型不是。可能生成同一张图片的提示词空间大得惊人,而真正起作用的变量——风格预设、负向提示词、种子值、各家模型对参数的处理方式——在输出里全都看不见。两条读起来完全不同的提示词,在同一模型上可能生成几乎一样的图。
这不意味着图片的逆向分析没有用,而是说它只能当启发式方法。实操者的做法:先仔细描述这张图,把描述当作草稿提示词,再从那里迭代;同时留意你想要的风格反复出现的关键词模式。提示词措辞始终是图像工作流里你能主动掌控的主要杠杆——无论你是在生成器里从零写提示词,还是把提示词和参考草图一起交给 SketchTo 的 Sketch to Render 这样的工具。区别在于:正向写提示词能得到可以据此调整的反馈,而从图片倒推通常得不到。
在相信一次重建之前,先知道这些局限
每一次重建都继承同样的四个弱点,来源资料里都有记录:
- 多条提示词都成立。"用大白话总结这篇文章"和"给我一份要点简明概览"产出相近的结果。输出相似不等于锁定提示词。
- 含糊的输出没法重建。 一句"创新是成功的关键"可能来自商业策略、励志写作或创业文化的提示词——没有任何可抓的线索。
- 隐藏的上下文始终看不到。 系统提示词、温度设置、对话历史、RAG 流程检索到的文档都会影响输出,而 RPE 对它们一无所知。
- 看得出偏见,找不到根源。 重建可以暴露输出中的偏见模式,但无法判断它来自提示词、训练数据还是模型的推理。
把 RPE 当作诊断工具:它能缩小可能提示词的范围、暴露输出的结构与意图,但并不能还原真正的指令,也还原不了塑造输出的参数。
结论
逆向提示词工程用一个结构化的方法回答一个简单的问题:给定模型的产出,它被问了什么?研究者只用少量输出、不接触模型内部,就能机械地精修重建结果。你也可以用七问清单对任何输出做同样的倒推——而且这套方法会诚实地告诉你什么时候该停止相信它的答案,这一点在图像生成上最明显:图片背后的提示词,大多数时候仍触不可及。
分享
SketchTo 团队
专注 AI 工具、图像处理和创意工作流的技术写作者。
相关文章
AI手办提示词怎么写:可复制的prompt模板与免prompt捷径
一套能直接粘贴到 ChatGPT 或 Gemini 的 AI 手办 prompt——包装、配件、底座、姿势逐项讲清怎么写,附真实效果预期和免 prompt 的生成器捷径。
如何把照片变成波普艺术:可复制的 Warhol 风 Prompt 与避坑修复
手把手教你把照片变成波普艺术:Warhol 四格、漫画网点、WPAP 几何三种风格的可复制 prompt,以及脸崩、网点过密、滤镜感三大失败的修复方法。
哈利波特动漫 AI:Malfoid 趋势解析与自制教程
你信息流里的哈利波特动漫片段是 AI 同人作品,不是官方动漫。Malfoid 趋势是什么、为什么在 2026 年 10 月爆发、片段制作流程与提示词模板,以及必须知道的版权边界。