MOSS-Image 是什么:OpenMOSS 开源图像模型,主打文字渲染与布局控制
MOSS-Image 是 OpenMOSS 团队新发布的开源开放权重文生图模型家族:包含 MOSS-Image-Base 和 MOSS-Image-SFT 两个 checkpoint,代码与权重全部公开,2026 年 10 月 16 日以 Apache 2.0 协议发布,同日还放出了 arXiv 技术报告。它的主打方向在开放权重模型里相当少见:不追求泛化的画面质感,而是专攻开源模型长期最弱的两件事——在图片里渲染密集、准确的文字,以及精确控制每个元素"放在哪"。(顺带一提:直接搜这个词组,出来的多半是苔藓植物照片;模型本身在 OpenMOSS GitHub 仓库和 Hugging Face上。)
哪怕只是偶尔关注图像模型,这次发布也值得花十分钟了解。下面讲清楚它是什么、能做什么、和你已经在用的生成器有什么区别,以及三种实际上手方式。
重点速览
- MOSS-Image 是一个 5B 参数的单流扩散 transformer(DiT),从零预训练,针对中英双语图内文字渲染和布局控制做了优化。
- 发布两个 checkpoint:Base(完整保留训练信息,适合训练 LoRA)和 SFT(在精选数据上微调,开箱即用的文字分组和排版更干净)。
- 最有辨识度的能力是 JSON 布局提示词:描述每个元素并给出边界框,模型按坐标组织画面。
- 按其技术报告的自报数据,在 LongLongTextBench 基准上取得 96.3% 的平均文字覆盖率——作者称这是开放权重模型中的最好成绩。
- 今天就能上手:浏览器里直接跑官方 Hugging Face Space,装 ComfyUI 插件,或用 diffusers 本地部署——没有名单,没有 waitlist。
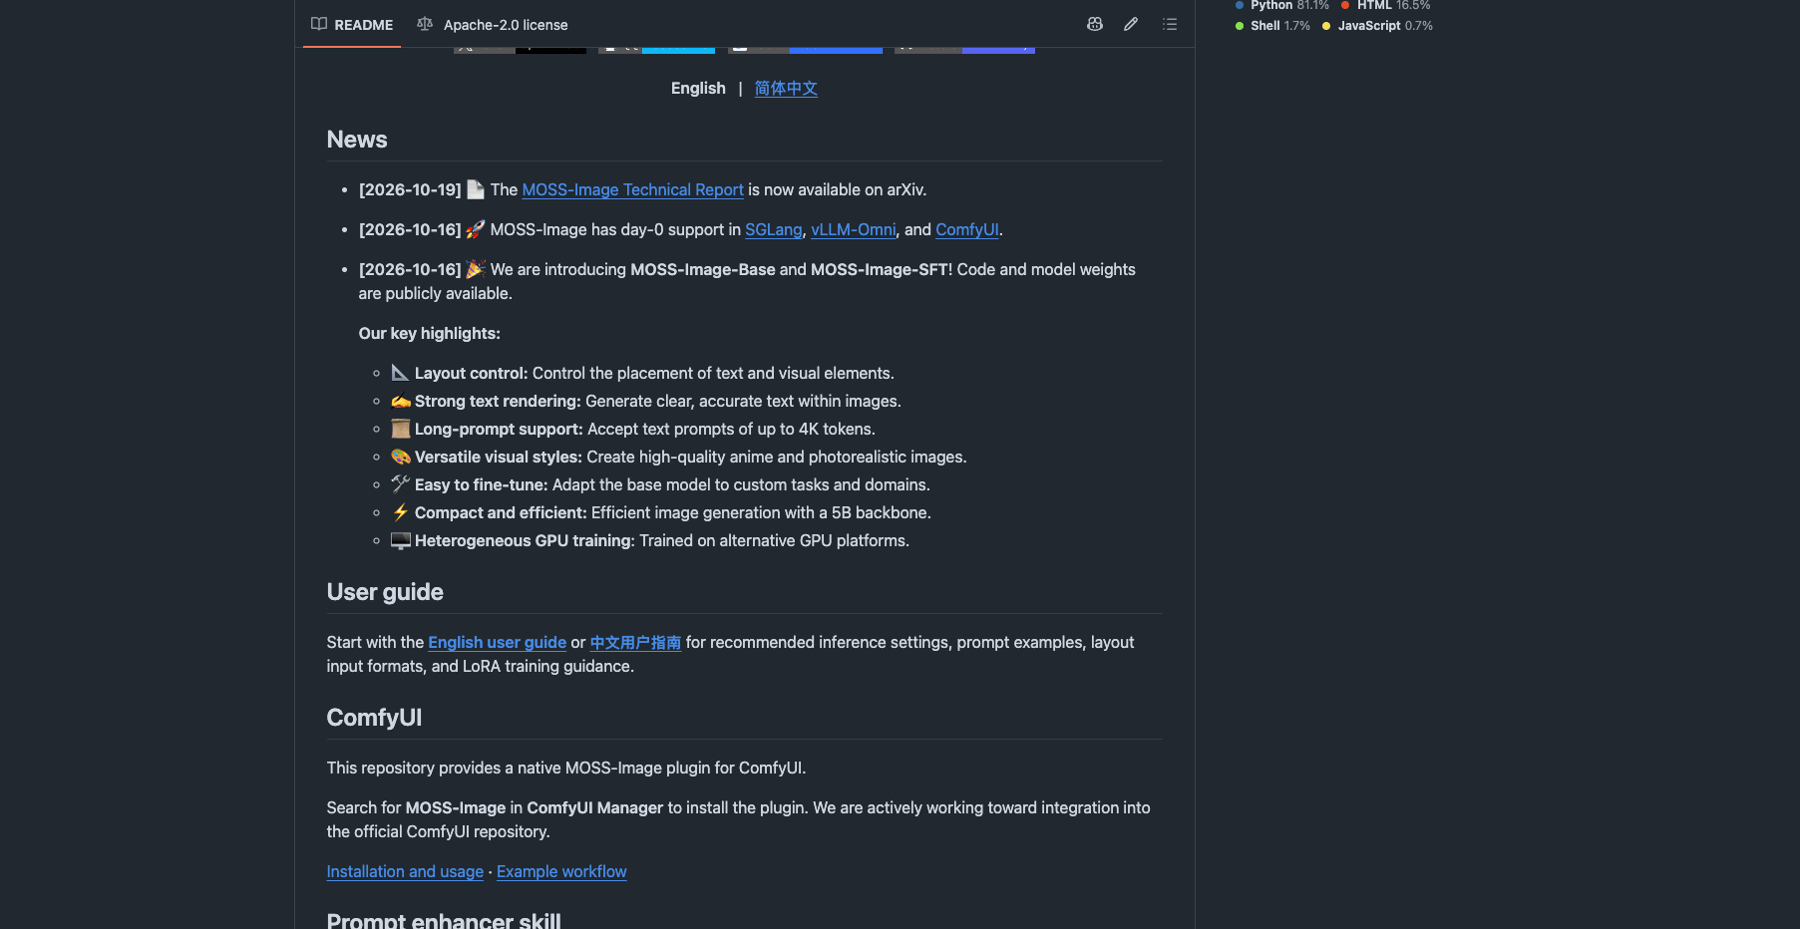
来源:GitHub 上的 OpenMOSS/MOSS-Image 仓库(2026 年 10 月 19 日访问)
MOSS-Image 到底是什么
MOSS-Image 来自 OpenMOSS,同一底座训练出两个模型:
| MOSS-Image-Base | MOSS-Image-SFT | |
|---|---|---|
| 定位 | 原始的 base 文生图模型 | Base 在精选数据上微调的版本 |
| 推理参数 | 未做 CFG 等推理参数的后训练或蒸馏 | 面向开箱即用效果做了调优 |
| 适合谁 | 社区 LoRA 训练、研究、自定义领域 | 直接生成,文字分组更清晰、排版更有条理 |
Base 模型刻意"完整保留"训练信息——团队明确把它定位成社区训练 LoRA 的底座(唯一的要求:微调时冻结 text encoder)。SFT 版本则用一部分灵活性换取更好的即用效果;在团队自己的对比示例里,SFT 生成的文字分组更清晰、白板式排版更有条理。
底层架构方面,技术报告描述了一个从零预训练的 5B 单流扩散 transformer。按当代图像模型的标准,这个规模相当紧凑——小到微调和自部署都现实可行,同时(报告认为)又足以承载信息密集的构图。
它能做什么
渲染真实文字——而且是双语
图内文字是大多数图像模型的滑铁卢:logo 自己拼错、海报长出乱码字符,中文字符的惨状更甚于拉丁字母。文字渲染正是 MOSS-Image 的头号卖点。技术报告为此提出了 LongLongTextBench(LLTB)——一个针对中英长文本渲染的基准——并报告了 96.3% 的平均文字覆盖率,作者称这是开放权重模型中的最高水平。这个数字应当理解为团队自己的基准成绩,而非独立评测的结论;但这项能力本身,无疑就是这次发布的重心。
官方用户指南里有两个实用细节:英文渲染效果最好(训练数据最多,中文也支持);想精确控制换行,直接在提示词里插入 \n,不用指望排版引擎猜中你的意图。
用 JSON 布局控制构图
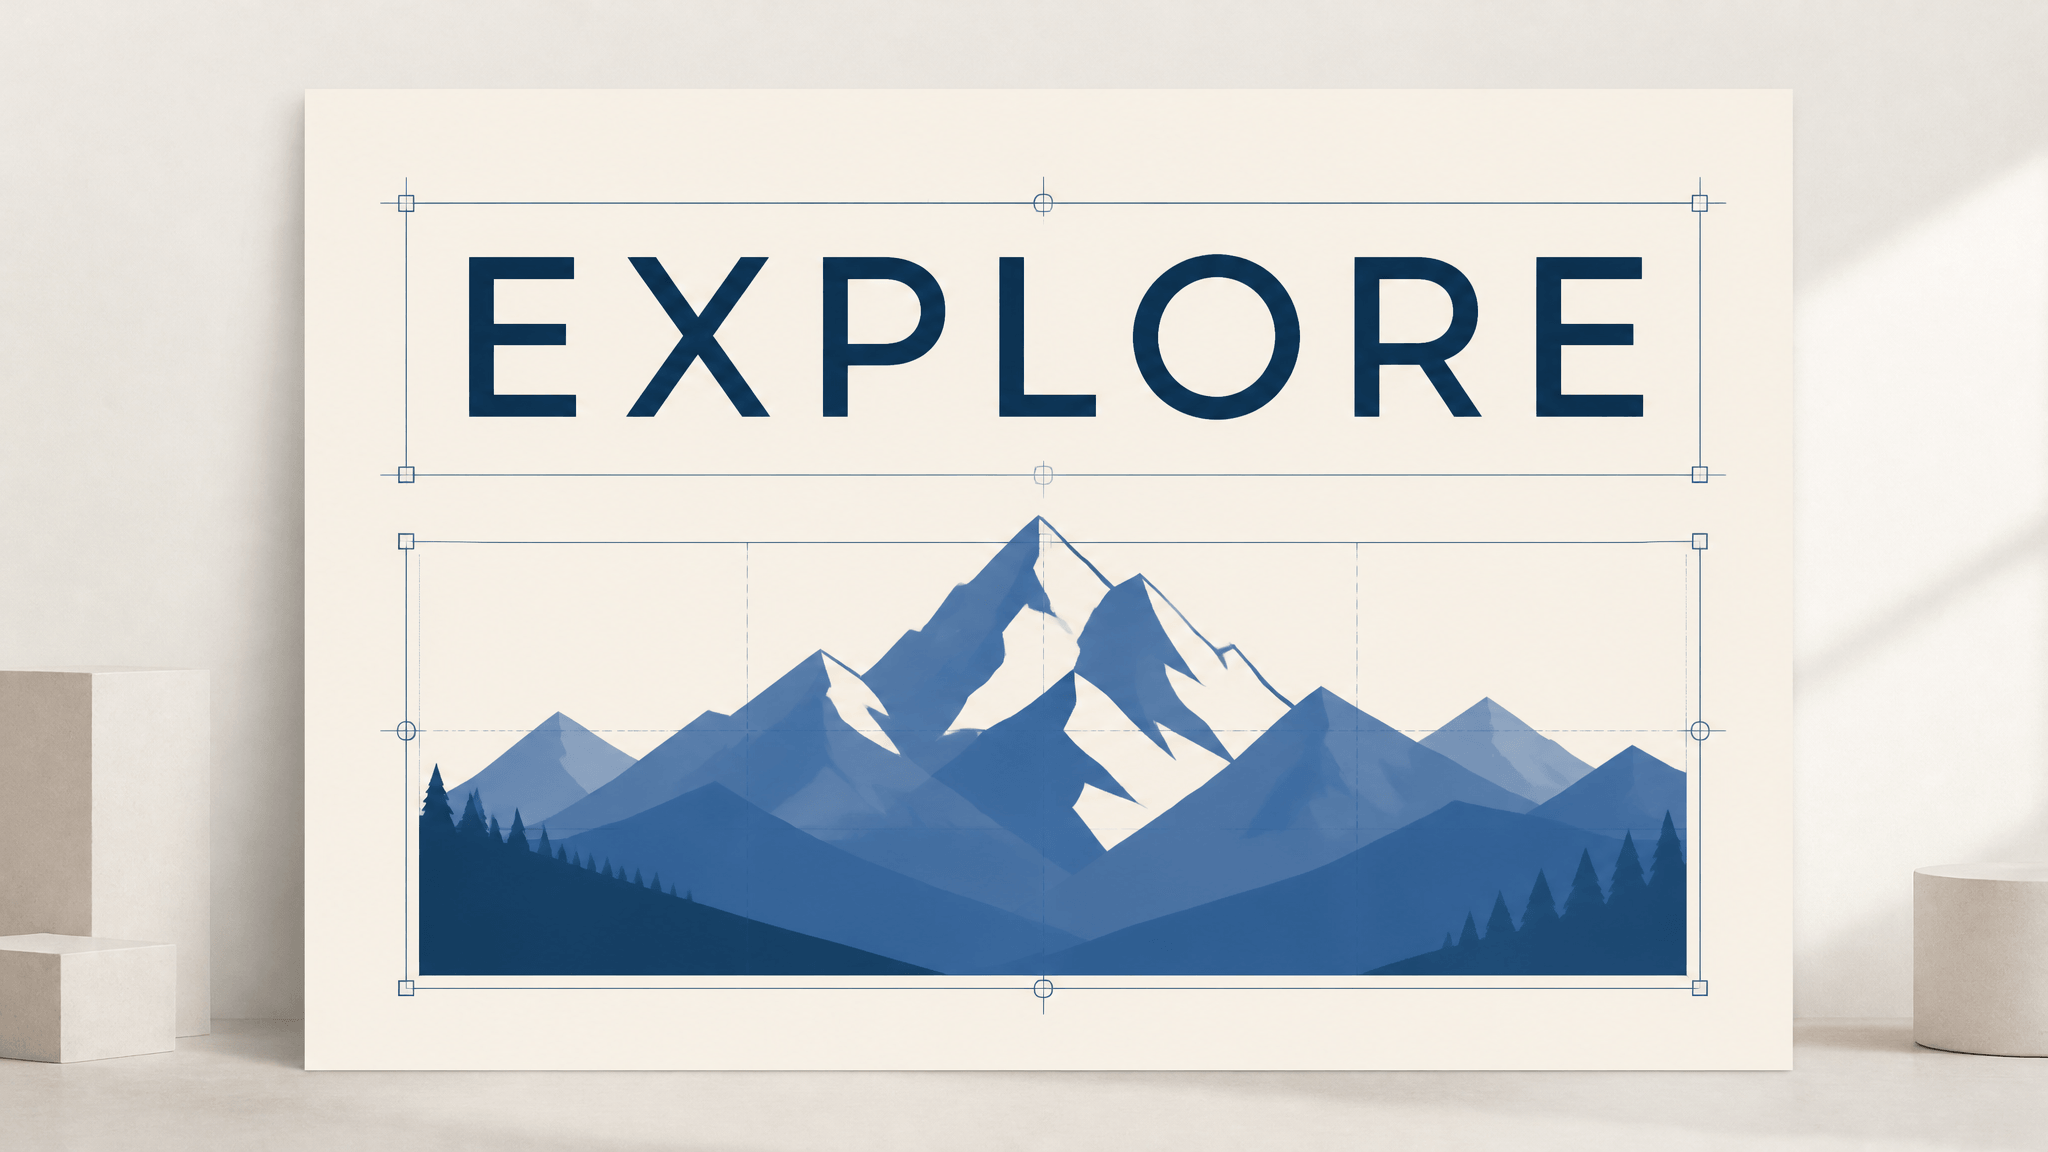
这是最具辨识度的功能。MOSS-Image 接受结构化的布局提示词:一个 JSON 对象描述整体场景,items 里逐个描述元素——每个元素带类别(label)、描述(caption)和边界框(bbox),渲染文字时还可以直接指定内容:
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue uppercase title centered at the top.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
边界框使用以画布中心为原点的绝对像素坐标(yxyx 顺序:y-min、x-min、y-max、x-max)。用户指南说明这是对近期一些相对坐标方案的有意取舍——作者认为绝对坐标在不同分辨率和宽高比之间迁移效果更好。这个功能标注为实验性,它也改变了"编辑"的方式:想移动标题或替换物体,改 JSON 然后重新生成——和编辑器里选中拖拽是两种完全不同的工作流。
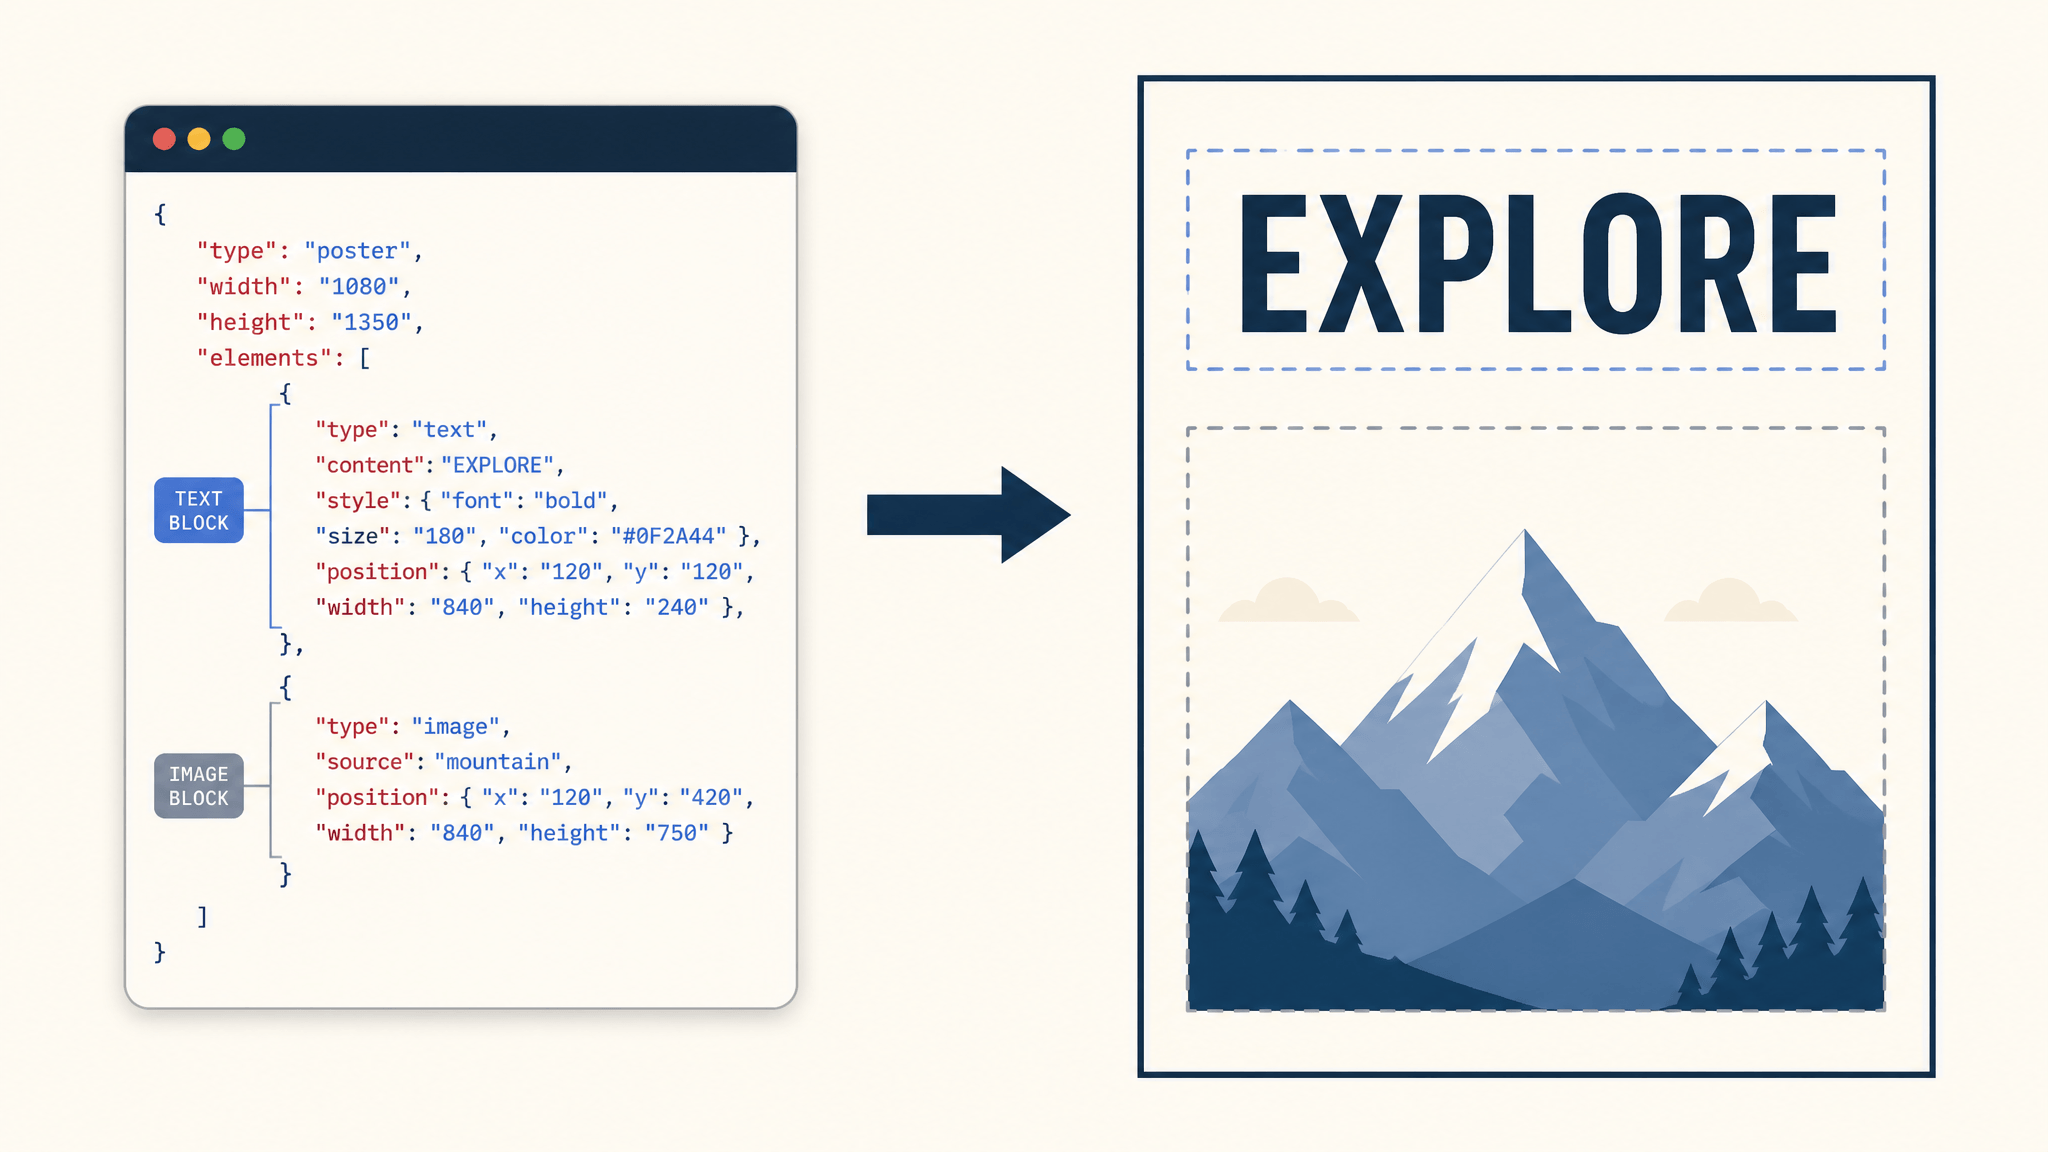
布局 JSON 工作流的概念示意;图中 schema 为通用示意,并非 MOSS-Image 的真实格式(真实格式见上方代码示例)。非真实模型输出。
吃得下长提示词,也吃得下多种输入
提示词最长支持 4K tokens,输入风格有三种:自然语言、danbooru 风格的 tag 序列(官方推荐顺序:Quality → Score → Meta → Year → Character → Series → Artist → General,明显照顾二次元模型的工作流),以及 JSON 布局。自然语言和结构化输入可以混用。发布还规划了 agentic 提示词增强器,把粗糙的需求转写为详细的内容与布局规格;免训练版本已作为 skill 放进仓库,微调版布局增强模型则预告为后续工作。
分辨率和风格自己定
推荐输出尺寸是 1M、1.5M 或 2M 总像素,并可在 0.25M(512×512)到 4M(2K)之间外推,宽高比任意——只要边长是 16 的倍数——而不是固定几张预设。风格方面,发布亮点列明高质量动漫和照片写实两种输出;tag 序列支持加上推荐的负面提示词组(nsfw, worst quality, bad anatomy, watermark, jpeg artifact),读起来就像是预料到二次元社区的工作流会第一天到场。确实到了:发布当天,SGLang、vLLM-Omni 和 ComfyUI 都完成了 day-0 支持。
它和其他图像模型的区别
不算完整对比——但有四点差异,足以帮你判断要不要关注:
- 控制面是一份契约,不是一个愿望。 多数文生图模型接收自然语言然后近似发挥;MOSS-Image 的布局 JSON 直接告诉它东西放在哪。技术报告的整体立论就是:开放权重模型输给闭源系统,恰恰输在密集文字和复杂布局上,而这门布局语言就是它用来补差距的机制。
- 两个 checkpoint,而不是一个。 多数发布只给一个微调后的模型。把未经后训练的 Base 和打磨过的 SFT 一起放出,是对开放生态的一次表态:你可以在一个推理行为没被后训练"揉过"的模型上训练 LoRA。
- 基准瞄准的是开源阵营。 按报告自报数字:在 RealLayoutArena(RLA)上,backbone 在"共享增强提示词"的评测条件下排第一,而完整系统在端到端对比中排第二——这个细节说得很诚实,因为提示词增强模块的贡献清晰可见。
- 紧凑且务实。 5B backbone、支持 SGLang 和 vLLM-Omni 服务栈、原生 ComfyUI 插件、在替代 GPU 平台上完成训练——所有信号都指向可用性,而不是只活在跑分里的展示品。
预期也要摆正:这是一个文生图生成器。没有上传照片、在图上刷笔修改的编辑能力——这里的"编辑"指调整布局 JSON 再重新生成——而让商业模型快到秒出图的少步数蒸馏(DMD 一类方法),也已公告为未来工作。
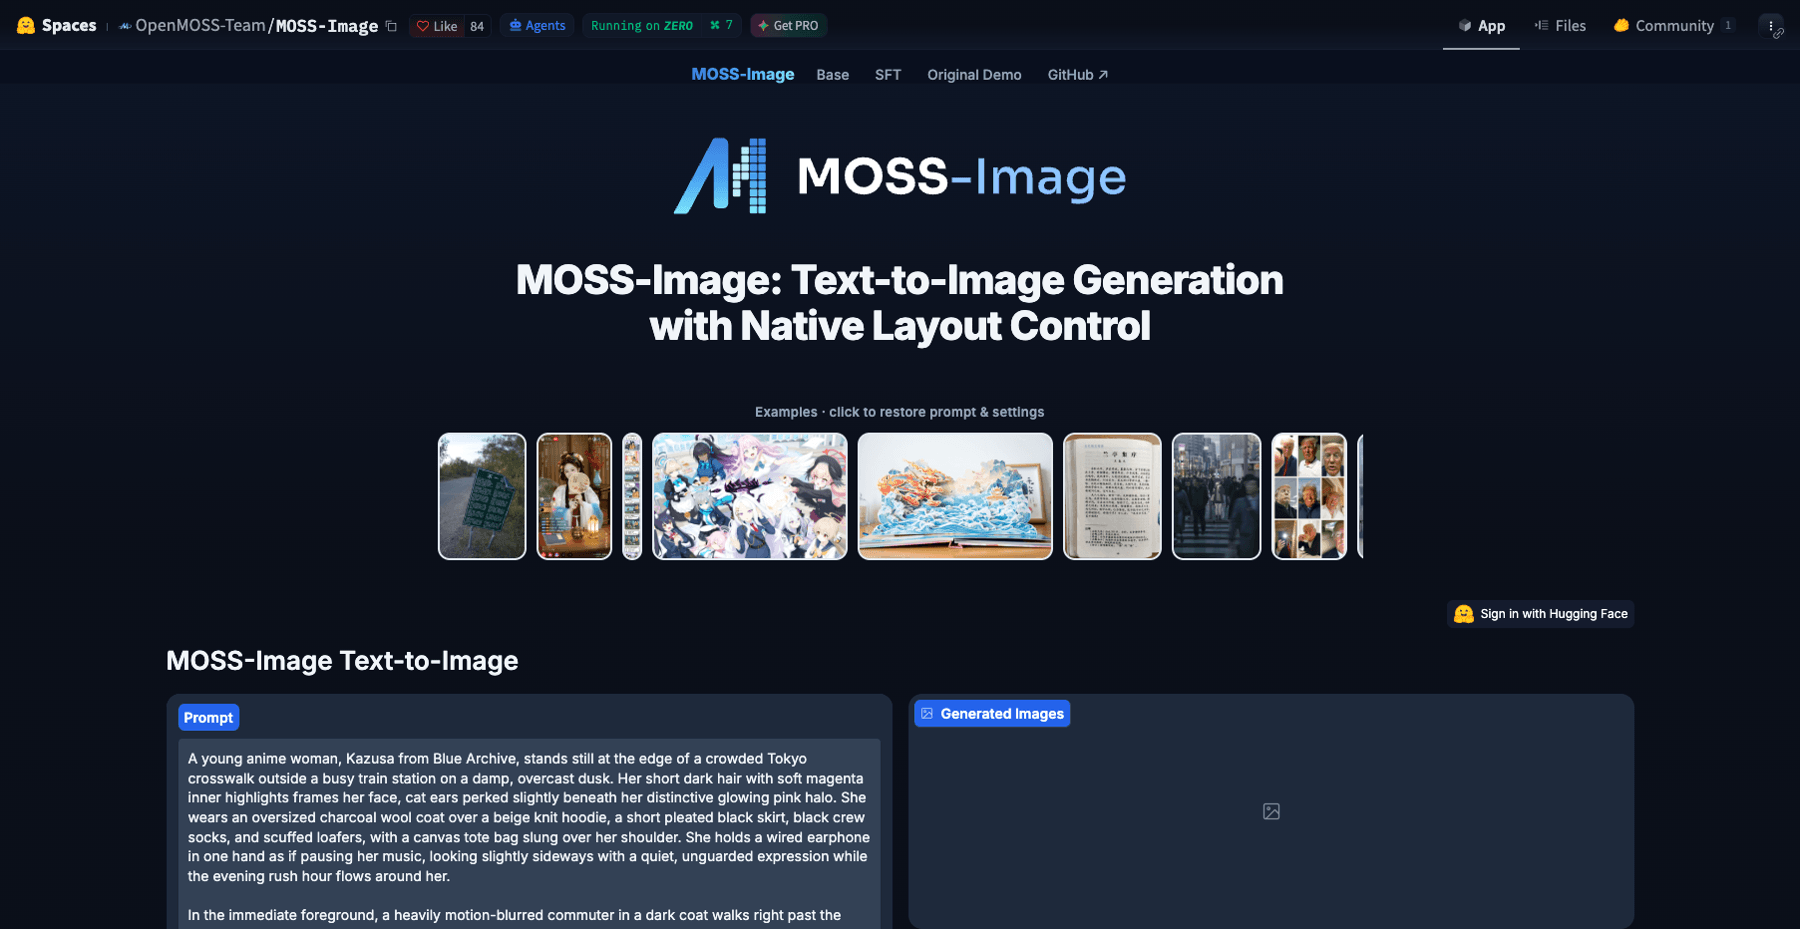
来源:Hugging Face 上的 OpenMOSS-Team/MOSS-Image Space(2026 年 10 月 19 日访问)
怎么上手
零部署——Hugging Face Space。 官方 demo Space 跑的就是仓库本地应用的 Gradio 界面:模型选择(Base 或 SFT)、正面/负面提示词框、分辨率与宽高比控制,外加 steps、CFG、Shift 和跳层引导的进阶滑杆。把上面的海报 JSON 直接粘进提示词框,把宽高设成匹配值即可。发布首周请做好排队的心理准备。
用 ComfyUI。 在 ComfyUI Manager 里搜 "MOSS-Image" 安装原生插件;仓库附带示例工作流。如果你是做模型服务的,SGLang 和 vLLM-Omni 在发布当天都已支持。
diffusers 本地跑。 需要 Python 3.10+、PyTorch 2.9+ 和 diffusers>=0.38;模型卡的 quickstart 通过自定义 pipeline_moss_image 管线加载 OpenMOSS-Team/MOSS-Image-Base。推荐采样设置:Euler 采样器、至少 50 步、CFG 3.0(短提示词可适当调高)、Shift 5.0,跳层引导用第 22 层做 negative-branch skip。显存紧张的话,Memory mode 下拉里有组件卸载和更慢的 Sequential 兜底。
值不值得关注
如果你要做海报、平面或营销素材,文字必须真的可读,那 MOSS-Image 是最值得盯的开源选项之一——文字渲染和布局控制正是它为补齐而生的地方。如果你训练 LoRA,一个未经后训练的 Base checkpoint 是实打实的好起点。如果你只是想出图、不想养 GPU,账就不这么算了:自部署一个 5B 扩散模型是爱好,托管工具——包括我们之前解读过的开源发布——依然是从提示词到图片的更快路径。
悬而未决的问题是 JSON 布局控制会不会普及。如果它成为人们指挥图像模型的方式——就像结构化 JSON 改变了我们与语言模型对话的方式——那 MOSS-Image 这次发布看起来就不只是又一个 checkpoint,而更像一份接口提案。换句话说,值得花这十分钟。
分享
SketchTo 团队
专注 AI 工具、图像处理和创意工作流的技术写作者。
相关文章
Qwen-Image-2.1 开源:7B 一个模型搞定文生图、编辑和透明素材
Qwen-Image-2.1 把文生图、图像编辑和原生 RGBA 透明收进一个 7B 开放权重模型。它能做什么、新在哪里、今天怎么跑起来——以及采用前必须知道的许可限制。
AI 图像生成成本对比:20 个模型同一张图实际扣了多少
OpenRouter 用同一个提示词实测 20 个图像模型并记录每一笔账单——同样一张 1:1 图片,$0.006 到 $0.134,价差 22 倍。看真实单张成本,以及怎么按预算选模型。
GPT-6 Astra 真实用例盘点:图像与设计工作里哪些是真的
按出处梳理 GPT-6 Astra 在图像与设计方向的真实用例——3D 世界、前端设计、媒体制作——以及它还不领先的短板和可用性、成本、耗时的现实约束。