Qwen-Image-2.1 GGUF:量化版本怎么选、显存要多少、ComfyUI 怎么跑
Qwen-Image-2.1 GGUF:量化版本怎么选、显存要多少、ComfyUI 怎么跑
Qwen-Image-2.1 于 2026 年 9 月 20 日开源,短短几天内社区就放出了它的 GGUF 量化版本——把模型压缩后塞进显存有限的消费级显卡。搜索「qwen image 2.1 gguf」的你,多半想知道两件事:这个新模型值不值得本地跑,以及自己的显卡该下哪个 GGUF 文件。先说结论:模型本身实力扎实——7B 参数、文生图与图像编辑一体、原生支持透明图像;如果你用 stable-diffusion.cpp、手头是较老的 AMD 显卡、或者想精确控制模型占用的显存大小,GGUF 是合适的选择。但具体到 ComfyUI 里,官方的 int8 权重反而往往更顺畅,而且走 GGUF 路线还有两个已知的坑要先避开。
本文把这些问题一次讲清:模型能做什么、完整的量化档位和真实文件大小、你的显存该选哪一档、ComfyUI-GGUF 的分步配置,以及几乎人人会踩的两个报错的解法。
要点速览
- Qwen-Image-2.1 把文生图和图像编辑统一在一个 7B 模型里,原生支持 RGBA 透明图像、最多 10 张参考图、原生 2K 输出。
- GGUF 文件只包含去噪器(transformer 部分),还需要单独下载 VAE 和 Qwen3-VL 8B 文本编码器两个配套文件。
- 量化档位从 Q2_K(2.47 GB)到 F16(14.2 GB),社区推荐 Q4_K_M(约 4.2 GB) 作为体积与质量的最佳平衡点。
- 在 ComfyUI 里加载 GGUF 必须用 leejet 的 ComfyUI-GGUF fork——原版加载器会报「Unknown model architecture!」;文本编码器必须用 Qwen3-VL 文件而不是 Qwen3.5 提示词增强模型,否则输出纯噪点。
- 如果你的显卡只有 6–8 GB 显存、内存约 32 GB,社区反馈官方 int8_convrot 权重不用 GGUF 也能正常跑;不想折腾本地环境的话,在线的 Qwen 图像编辑工具零下载就能用。
Qwen-Image-2.1 到底带来了什么
Qwen-Image-2.1 是阿里最新的开源图像模型,2026 年 9 月 20 日发布,权重挂在 Hugging Face 和 ModelScope 上。视觉生成核心只有 7B 参数、32 层单流 DiT——按现在的标准刻意做小——搭配 Qwen3-VL 8B 文本编码器和 64 通道 RGBA VAE。一个模型同时覆盖文生图、图像编辑和透明图像处理:
- 原生透明:能生成普通或透明(RGBA)图像、编辑透明图层、从照片里抠出主体。
- 多参考图编辑:最多 10 张参考图,针对人物和商品做了身份一致性优化。
- 精确局部编辑:用圆圈、涂抹标注或独立掩码指定修改区域,而不是靠提示词碰运气。
- 原生 2K 分辨率:官方推荐的比例表从 1:1(2048×2048)到 16:9(2752×1536),默认 40 步采样。
这次发布对图像工作流的整体影响,我们在Qwen-Image-2.1 发布解读里有更完整的分析;官方博客则提供了详细的评测对比。这篇文章聚焦大家搜索最多的那部分:GGUF 版本的本地部署。
「GGUF」对这个模型意味着什么
GGUF 是 llama.cpp 带火的单文件模型格式。对图像模型来说,GGUF 文件里装的是量化后的去噪器——真正干生成活的 transformer——而不是完整管线。要用 GGUF 跑 Qwen-Image-2.1,你需要三个文件:
| 组件 | 文件 | 作用 |
|---|---|---|
| 去噪器(GGUF) | 如 qwen-image-2.1-Q4_K_M.gguf |
量化后的 transformer——你要下载的主体 |
| 文本编码器 | qwen3vl_8b_bf16.safetensors 或 int8 版 |
把提示词编码为条件输入;Qwen3-VL 8B |
| VAE | qwen_image_2.1_vae_bf16.safetensors |
把结果解码成像素;约 676 MB |
Unsloth 的 Qwen-Image-2.1-GGUF 仓库是目前下载量最高的中立量化版本;发布后约 9 天内,Hugging Face 上出现了约 65 个匹配的 GGUF 仓库(截至 2026 年 9 月 29 日的统计)。同一批 GGUF 文件在 ComfyUI 之外也能跑——stable-diffusion.cpp 和 Unsloth Desktop 可以直接加载,这对 AMD 显卡用户和喜欢轻量工具的人很重要。
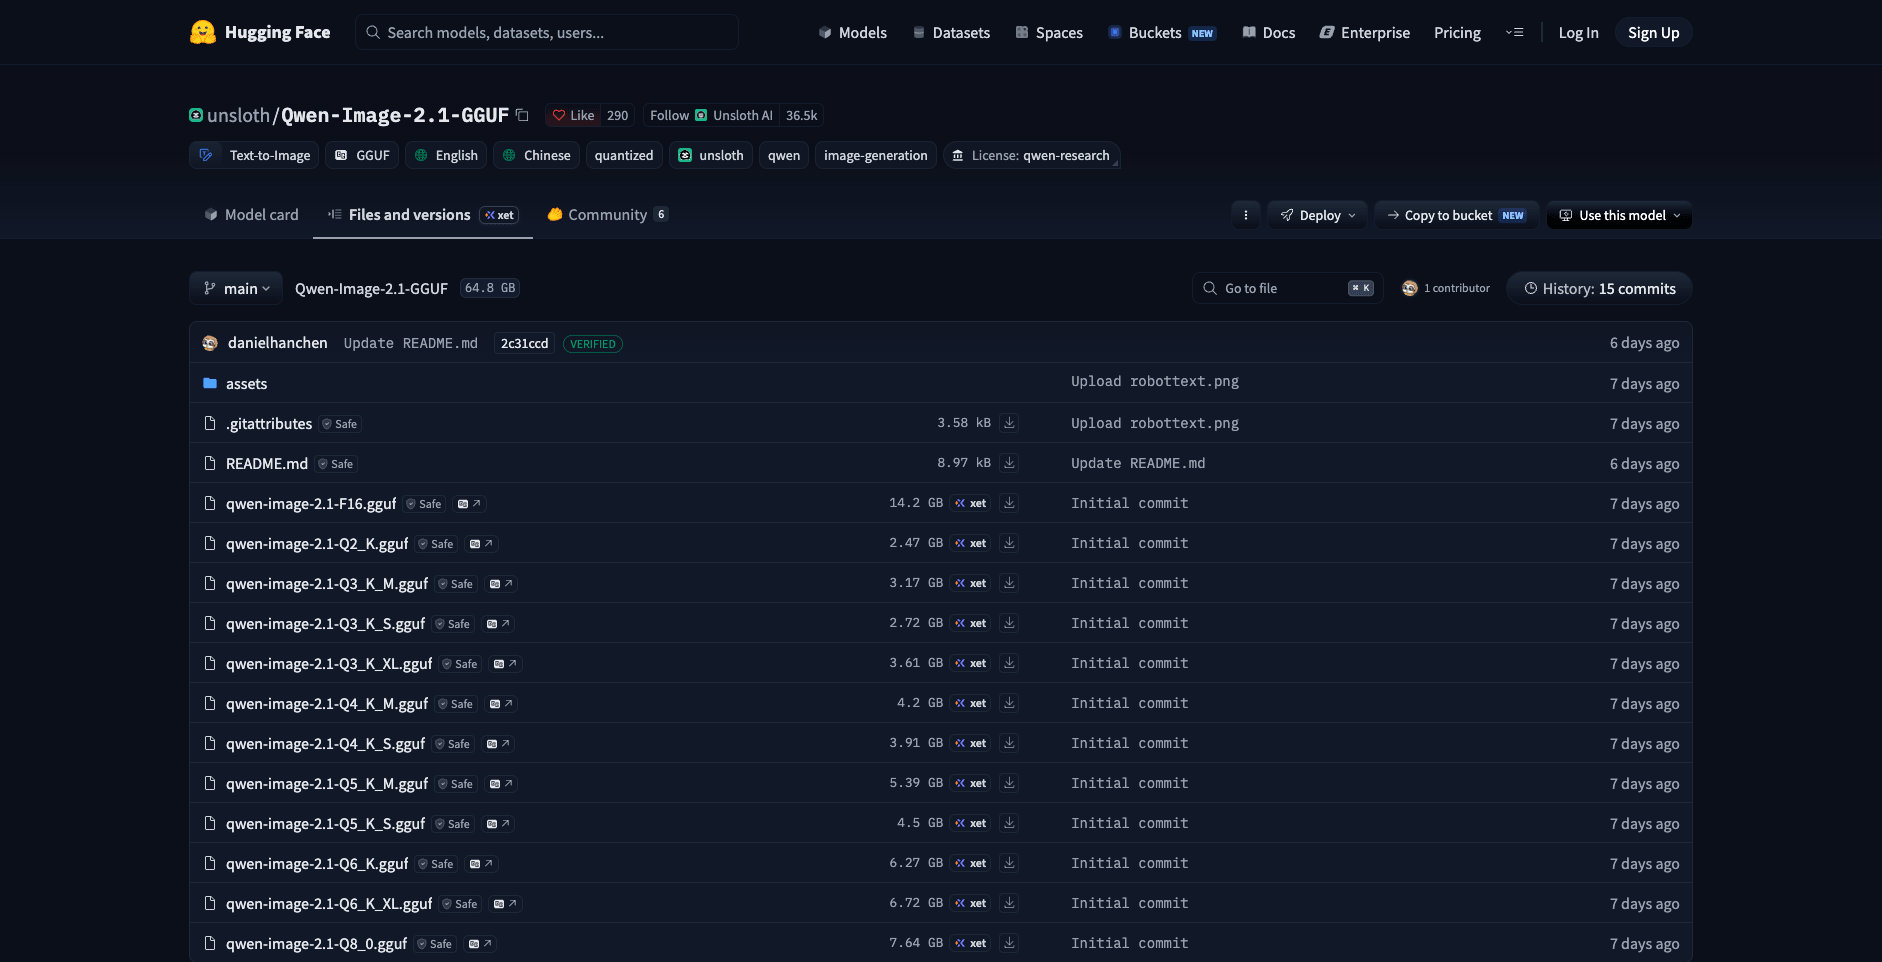
unsloth 仓库的文件列表标注了每个量化档位的精确体积。(截图来源:huggingface.co/unsloth/Qwen-Image-2.1-GGUF,2026 年 9 月 29 日截取)
unsloth 仓库的文件列表标注了每个量化档位的精确体积。(截图来源:huggingface.co/unsloth/Qwen-Image-2.1-GGUF,2026 年 9 月 29 日截取)
量化档位全表:每一档的真实体积
以下是 unsloth 仓库的完整档位,按体积排序:
| 量化档位 | 文件大小 | 适合谁 |
|---|---|---|
| Q2_K | 2.47 GB | 应急选项;画质损失明显 |
| Q3_K_S | 2.72 GB | 显存极度紧张;多数场景已低于可用质量线 |
| Q3_K_M | 3.17 GB | 显存紧张 |
| Q3_K_XL | 3.61 GB | 低端配置,敏感层做了精度回补 |
| Q4_K_S | 3.91 GB | 低显存但重视画质 |
| Q4_K_M | 4.2 GB | 多数显卡的推荐平衡点 |
| Q5_K_S | 4.5 GB | 想要更高保真度的 6–8 GB 显卡 |
| Q5_K_M | 5.39 GB | 显存充裕的 8 GB 显卡 |
| Q6_K | 6.27 GB | 8–12 GB 显卡;视觉上已非常接近全精度 |
| Q6_K_XL | 6.72 GB | 同上,敏感层精度更高 |
| Q8_0 | 7.64 GB | 12 GB 以上显卡;几乎无损 |
| F16 | 14.2 GB | 全精度;16 GB 以上显卡才有意义 |
读这张表有两个实用提醒。第一,文件大小只是下限,不是最终显存账单——采样时的激活值和注意力机制会带来额外开销,所以要在文件体积之上留出余量。第二,档位命名编码了质量信息:K 系量化会把「重要」的张量保留在更高精度,XL/S/M 后缀控制回补的激进程度。仓库维护者推荐 Q4_K_M 作为体积与质量的最佳平衡,社区实测基本认同;Q3 以下开始出现文字渲染退化和纹理瑕疵。
综合仓库文档和社区反馈(而非我们自己的实测),一个合理的规划参考是:Q4_K_M 去噪器加上转入内存的文本编码器,大约 6 GB 显存起步就能比较从容地跑起来——前提是文本编码器放在系统内存里(下文详述)。最下面两档当实验来玩可以,当日常主力不行。
下载之前:ComfyUI 里 GGUF 对比官方 int8_convrot
先把丑话说在前面,帮你省下流量:在 ComfyUI 里,GGUF 并不自动等于低显存最优解。 ComfyUI 官方转存的权重(Comfy-Org/Qwen-Image-2.1)除了 bf16 原版还带一份 int8_convrot 扩散模型,而 ComfyUI 的动态显存管理——那套让大模型在小显卡上也能跑的权重换流机制——就是围绕 bf16/fp8/int8 设计的。社区讨论和 ComfyUI 维护者都提到,GGUF 文件在 ComfyUI 里会退回更老、更慢的内存管理路径。同一批用户反馈 int8_convrot 权重在 6–8 GB 显存、约 32 GB 内存的机器上跑得很稳。
那 GGUF 到底适合谁?
- stable-diffusion.cpp / koboldcpp / Unsloth Desktop 用户:这些工具原生加载 GGUF,完全绕开 ComfyUI 的内存管理器。
- 较老的 AMD 显卡(RDNA3 之前)和其他边缘硬件:GGUF 的 CPU+GPU 分工往往是最省事的路线。
- 想要特定体积档位的人:GGUF 提供官方 int8/fp8 阵容没有的 5-bit、6-bit 档位。
如果你是显存现代的 N 卡用户、内存也够,先下官方 int8_convrot 权重是文档明确、阻力更小的路线。如果你还是想要 GGUF——为了更细的档位控制或非 ComfyUI 运行时——照下面的配置来。
ComfyUI-GGUF 分步配置
以下流程基于文档整理:步骤来自社区维护的 GGUF 仓库 README 和 leejet fork 的改动记录,并与社区排错帖交叉核对——我们并未亲自逐步运行验证。
1. 先更新 ComfyUI。 GGUF 加载器依赖较新版本的 ComfyUI 自定义算子支持来加载纯 UNET。动手之前先跑一遍常规更新(Windows 便携版就是 update.bat)。
2. 安装 leejet 的 ComfyUI-GGUF fork——不是原版。 原版 city96/ComfyUI-GGUF 节点包不认识 Qwen-Image-2.1 的架构,会直接报「Unknown model architecture!」。leejet fork 加入了 Qwen-Image 2.1 支持并修复了 Qwen3-VL 权重识别:
cd ComfyUI/custom_nodes
git clone https://github.com/leejet/ComfyUI-GGUF
pip install -r ComfyUI-GGUF/requirements.txt
如果之前装过 city96 原版,先删掉或换成 fork,再排查其他问题。
3. 下载三个文件,放进对应的目录:
ComfyUI/
└── models/
    ├── diffusion_models/
    │   └── qwen-image-2.1-Q4_K_M.gguf      # 选你的量化档位
    ├── text_encoders/
    │   └── qwen3vl_8b_int8_convrot.safetensors   # 或 bf16 版
    └── vae/
        └── qwen_image_2.1_vae_bf16.safetensors
文本编码器和 VAE 来自 Comfy-Org 官方转存权重;去噪器来自你选的 GGUF 仓库。注意文本编码器要用 Qwen3-VL 8B 的文件——不是同一个 Comfy-Org 仓库里那两个 qwen3.5_9b 提示词增强模型。搞混了就是下面的故障一。
4. 加载官方工作流模板,换掉加载节点。 Comfy-Org 发布了文生图和图像编辑两套模板。加载后,把默认的 UNETLoader(Load Diffusion Model)节点换成 Unet Loader (GGUF),指向你的 .gguf 文件。
5. 接好文本编码器和 VAE。 在模板的 CLIPLoader 里选中你的 qwen3vl_8b 文件,类型设为 qwen_image;VAELoader 继续指向 qwen_image_2.1_vae_bf16.safetensors。
6. 按文档推荐的方式分配内存。 GGUF 去噪器留在显卡上——采样速度靠它;文本编码器放到(或卸载到)系统内存。文本编码每个提示词只跑一次,这样能省下约 9–17 GB 显存,速度损失很小:社区推荐的组合是约 4.6 GB 的 Q4_K_M 去噪器驻留显存、约 9.35 GB 的 int8 文本编码器待在内存里。如果还是爆显存,启动 ComfyUI 时加 --lowvram 参数。
人人都会踩的两个故障
网上「Qwen GGUF 跑不起来」的帖子,绝大多数逃不出这两种:
- 输出全是噪点。 文本编码器拿错了。GGUF 工作流需要 Qwen3-VL 8B 编码器;错用 Qwen3.5-9B 提示词增强文件就会输出噪点。把 CLIPLoader 换成
qwen3vl_8b文件即可。 - 加载时报「Unknown model architecture!」。 你在用 city96 原版加载器。安装或更新到 leejet fork(上面的第 2 步),并确认 ComfyUI 本体也是最新。
这两个修复都比重下模型快,先查它们,别急着怪显卡。
不用 ComfyUI 也能跑
如果你的工作流里没有 ComfyUI,stable-diffusion.cpp 可以直接加载这批 GGUF 文件。unsloth 仓库给出了一行式示例:
sd-cli --diffusion-model qwen-image-2.1-Q4_K_M.gguf \
  --vae qwen_image_2.1_vae_bf16.safetensors \
  --llm Qwen3-VL-8B-Instruct-UD-Q4_K_XL.gguf \
  -p "你的提示词" \
  --steps 20 --cfg-scale 6.0 --sampling-method euler -W 1024 -H 1024
这也是 GGUF 在老 AMD 硬件上的价值所在:Qwen 为 Radeon 显卡提供了 ROCm/PyTorch 路线,而 llama.cpp 风格的工具通常对非 CUDA 系统最友好。不想碰终端的话,Unsloth Desktop 把同样的模型包进了图形界面。
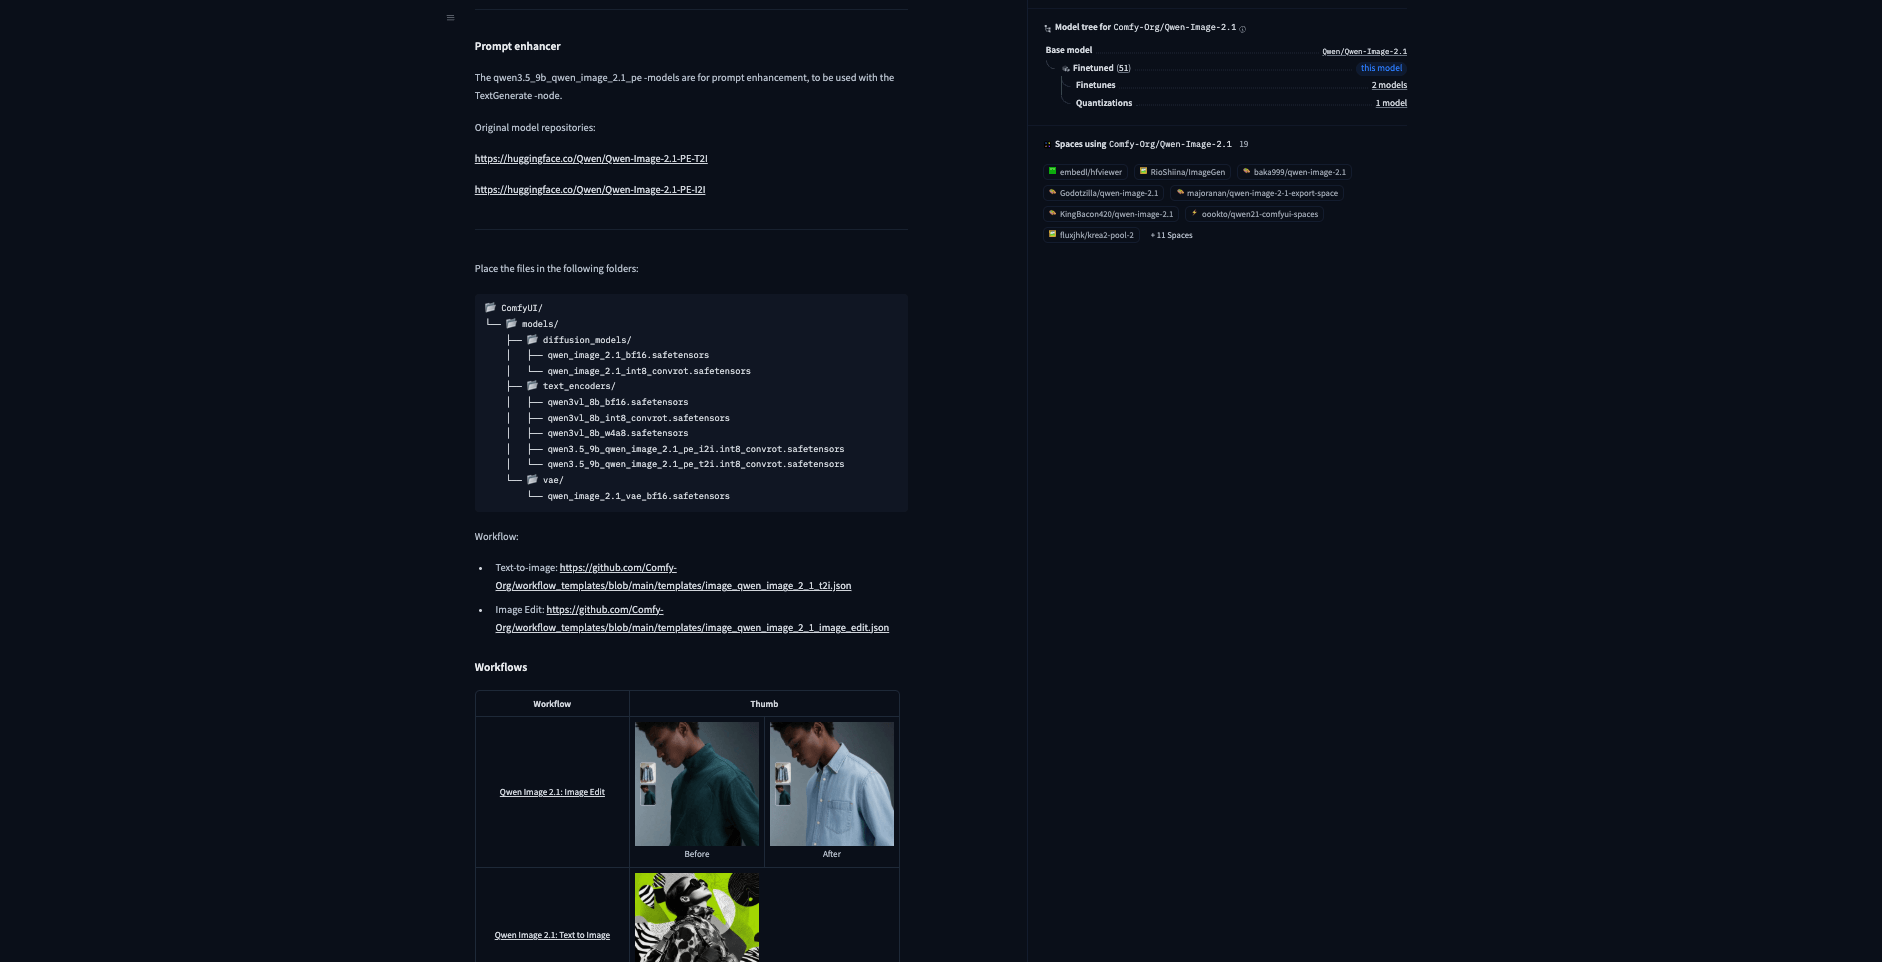
Comfy-Org 官方模型卡标注了配套权重的确切目录位置。(截图来源:huggingface.co/Comfy-Org/Qwen-Image-2.1,2026 年 9 月 29 日截取)
Comfy-Org 官方模型卡标注了配套权重的确切目录位置。(截图来源:huggingface.co/Comfy-Org/Qwen-Image-2.1,2026 年 9 月 29 日截取)
不想折腾本地环境?
上面这一切,值得的前提是你想要免费、无限、离线的生成,并且不介意管理模型文件。如果你主要是要编辑结果——换背景、改物体、迁移风格——也可以直接用在线的 Qwen 图像编辑工具,零下载:SketchTo 在浏览器里提供 Qwen Image Edit 在线编辑,每次编辑 3 积分,注册就送免费体验积分。它是另一条 Qwen 模型产品线(20B 的 Qwen Image Edit,不是这次新的 7B 版本),但对快速修图来说,整个量化-fork-工作流的折腾都可以跳过。
结论
三句话覆盖全部决策。第一,按显存选档位:拿不准就 Q4_K_M,显存充裕上 Q6_K/Q8_0,正式用途别低于 Q3。第二,在 ComfyUI 里跑,leejet fork 加 Qwen3-VL 文本编码器是两个必避的坑——而且下载任何 GGUF 之前,值得先试试官方 int8_convrot 权重。第三,按硬件选运行时:新 N 卡用 ComfyUI,其他配置用 sd.cpp 或 fork 加载器——或者干脆跳过这一切,在线修图。
分享
SketchTo 团队
专注 AI 工具、图像处理和创意工作流的技术写作者。
相关文章
怎么定制属于自己的 Funko Pop?三条真实路线 + 真实费用与周期
Funko 官方定制器、平台手工工作室、还是自己动手改?对比定制专属 Funko Pop 的真实价格与周期,并在花钱前用 AI 免费预览设计。
如何用 AI 修复老照片:实测提示词与真实点数成本
我们在 SketchTo 上用三条可复制的 AI 提示词修复一张受损老照片——损伤修复、保脸锐化、可选上色——并如实报告真实点数消耗、修复前后对比与局限性。
拼豆图纸怎么做?照片生成可打印图纸的零基础教程
手把手教你把照片变成可打印的拼豆图纸:免费在线工具实测生成、读懂网格图纸、按色号备料、双面熨烫定型全流程,附珠子尺寸与 Perler/Hama/Artkal 色号对照选购指南。